Neste artigo
- Antes do JEV: os dois sistemas de Daniel Kahneman
- Da mente humana para o software
- O que é JEV?
- Quem criou o JEV
- Por que o JEV não é simplesmente outro LLM?
- A ideia por trás dos System One Models
- Como o JEV funciona?
- Como acessar
- O diferencial mais importante: decisões probabilísticas
- O que os testes independentes mostram até agora
- "JEV não alucina?" A resposta é mais complexa
- JEV é mais barato e mais rápido que um LLM?
- Segundo a TypeSafe
- Em avaliações independentes
- JEV vs GPT, Claude e Gemini
- JEV + LLM: o verdadeiro potencial pode estar na combinação
- JEV e AI Agents: o sistema nervoso dos agentes
- Onde o JEV pode ser utilizado?
- Onde o JEV ainda precisa provar seu valor
- JEV e Decision Intelligence
- O que o JEV pode significar para o futuro da IA?
- JEV pode criar uma nova categoria de IA?
- O que empresas deveriam observar ao avaliar o JEV
- JEV em 5 pontos
- Perguntas frequentes sobre o JEV
- Perguntas frequentes
- Conclusão: talvez uma nova camada da arquitetura de IA
E se a próxima evolução da inteligência artificial não fosse uma IA que conversa melhor, mas uma IA que decide?
Antes do JEV: os dois sistemas de Daniel Kahneman
Para entender o JEV, vale começar longe da tecnologia: na psicologia. O psicólogo Daniel Kahneman, Prêmio Nobel de Economia em 2002, dedicou décadas a estudar como as pessoas tomam decisões. Em Rápido e Devagar: duas formas de pensar (2011), ele organizou esse trabalho em uma metáfora que se tornou uma das mais conhecidas da ciência comportamental: a mente humana opera com dois modos de pensamento, que ele chamou de Sistema 1 e Sistema 2.
O Sistema 1 é o modo rápido. Ele funciona de forma automática, quase sem esforço e sem a sensação de que se está no controle. É ele que percebe que um rosto está irritado antes de qualquer palavra, que completa "arroz com..." sem hesitar, que responde quanto é 2 + 2 e que conduz o carro em uma estrada vazia enquanto a conversa segue no banco de trás. O Sistema 1 reconhece padrões, classifica situações e dispara respostas em frações de segundo.
O Sistema 2 é o modo lento. Ele entra em cena quando a tarefa exige atenção deliberada: calcular 17 × 24 de cabeça, preencher a declaração do Imposto de Renda, comparar dois contratos cláusula por cláusula ou estacionar em uma vaga apertada. É o sistema que raciocina passo a passo, planeja e justifica. Também é caro: consome energia, tempo e concentração.
| Sistema 1 | Sistema 2 | |
|---|---|---|
| Velocidade | Rápido, quase instantâneo | Lento, sequencial |
| Esforço | Automático, sem esforço percebido | Deliberado, exige concentração |
| O que faz bem | Reconhecer, classificar, reagir | Raciocinar, planejar, explicar |
| Exemplo | "Essa mensagem parece golpe" | "Vou analisar cada item desta fatura" |
| Ponto fraco | Vieses e atalhos que levam a erro | Custo alto e capacidade limitada |
Dois detalhes dessa teoria importam para o que vem a seguir. O primeiro é que o Sistema 1 faz a maior parte do trabalho do dia a dia: o Sistema 2 só é acionado quando o primeiro não dá conta. O segundo é que o Sistema 1 erra, e boa parte da obra de Kahneman documenta justamente os vieses que nascem desses atalhos mentais. Velocidade e confiabilidade, portanto, não andam juntas por natureza.
Da mente humana para o software
Agora, transporte essa metáfora para a inteligência artificial. Os grandes modelos de linguagem (LLMs), como GPT, Claude e Gemini, se tornaram extraordinariamente bons em tarefas de Sistema 2: escrever, explicar, planejar, gerar código e encadear raciocínios longos. Eles pensam "escrevendo", um token de cada vez.
O problema é que a maior parte das decisões que acontecem dentro de um software é de Sistema 1. Este e-mail é spam? Este chamado é urgente? Para qual fila esta nota fiscal deve ir? Este documento é relevante para a pergunta? O agente deve chamar a ferramenta A ou a B? São perguntas curtas, repetidas milhões de vezes, que precisam de uma resposta rápida, estruturada e confiável, não de um parágrafo bem escrito.
Hoje, muitas empresas resolvem essas microdecisões "alugando" o Sistema 2: enviam a pergunta a um LLM, esperam alguns segundos pela geração de texto, fazem o parsing da resposta, validam o formato e torcem para que o modelo não tenha saído do roteiro. Funciona, mas é como chamar um consultor sênior para decidir se um e-mail vai para a caixa de entrada ou para o lixo.
É exatamente nesse espaço que surge o JEV, da TypeSafe AI: um modelo que abre mão de gerar texto para fazer muito bem uma coisa só: decidir. A própria empresa batizou a categoria de System One Models, em referência direta ao Sistema 1 de Kahneman.
A primeira geração de IA ensinou máquinas a gerar. A próxima pode ensiná-las a decidir.
O que é JEV?
JEV é um modelo de inteligência artificial da TypeSafe AI projetado para transformar contexto em decisões estruturadas e probabilísticas. Diferentemente dos LLMs tradicionais, seu objetivo não é gerar texto, mas fornecer decisões que podem ser usadas diretamente por aplicações, workflows e AI Agents.
Na prática, o modelo recebe o estado de um programa (um texto, um objeto JSON ou uma lista de textos) junto com uma ou mais perguntas tipadas. Em vez de escrever uma resposta, ele devolve o valor escolhido, a probabilidade de cada opção e um indicador de confiança. A TypeSafe resume a proposta como uma chamada de função com inteligência de fronteira: estado não estruturado na entrada, decisão tipada e probabilística na saída.
Contexto (e-mail, ticket, transação, documento)
   ↓
JEV
   ↓
Decisão tipada + probabilidade + confiança
   ↓
Software age (automatiza, pede evidência ou escala para humano)
Alguns exemplos do tipo de resposta que o JEV entrega:
É fraude?                    → SIM (96%)
Precisa de revisão humana?   → SIM (91%)
Qual categoria?              → Financeiro
Qual prioridade?             → Alta
Quem criou o JEV
O JEV foi apresentado em 15 de setembro de 2026, em acesso antecipado (early access), pela TypeSafe AI, empresa de São Francisco fundada em 2024 por Diogo Almeida, Erik Gafni e Sasha Sheng. Almeida, CEO da companhia, passou cerca de quatro anos na OpenAI trabalhando com RLHF, InstructGPT, ChatGPT e GPT-4, segundo o verbete do modelo na Wikipedia. O lançamento veio acompanhado de uma rodada seed de US$ 40 milhões liderada pela DCVC, que, de acordo com a Forbes, avaliou a empresa em US$ 200 milhões.
O nome oficial é grafado "Jev" e homenageia o economista William Stanley Jevons. O chamado paradoxo de Jevons descreve como a queda no custo de um recurso pode aumentar, e não reduzir, seu consumo total. A aposta da TypeSafe é que, quando uma decisão inteligente custar quase nada, as empresas passarão a automatizar milhares de decisões que hoje nem consideram entregar a uma IA.
O JEV é um modelo proprietário: não tem pesos abertos e é acessado por API.
Por que o JEV não é simplesmente outro LLM?
A diferença mais importante está na forma da saída. Um LLM produz uma sequência de tokens: texto livre, que pode ser um poema, um trecho de código, um JSON ou até uma resposta inventada. Para ser usado por software, esse texto precisa ser interpretado e validado. O JEV inverte a lógica: as respostas possíveis são definidas antes da chamada, e o modelo só pode escolher entre elas.
A segunda diferença está na forma de geração. LLMs são autorregressivos: cada token é gerado a partir dos anteriores, em sequência. O JEV é descrito como não autorregressivo: calcula as probabilidades de todas as respostas de uma vez, em uma única passagem paralela. É daí que vem a promessa de latência na casa dos milissegundos.
A terceira diferença está no treinamento. Os LLMs de conversação são refinados com RLHF (aprendizado por reforço com feedback humano) e, mais recentemente, com RLVR (recompensas verificáveis). A TypeSafe criou o RLCD (Reinforcement Learning for Calibrated Decisions), que otimiza as probabilidades contra resultados, e não contra a preferência de avaliadores humanos. Almeida, que ajudou a desenvolver o RLHF na OpenAI, resumiu a crítica à Forbes: os modelos atuais foram otimizados para agradar pessoas.
| LLM tradicional | JEV | |
|---|---|---|
| Saída | Texto (sequência de tokens) | Valor tipado + probabilidades + confiança |
| Formato | Aberto, precisa de parsing | Definido antes da chamada |
| Geração | Sequencial, token a token | Paralela, em uma única passagem |
| Treinamento | RLHF / RLVR | RLCD |
| Otimizado para | Respostas que humanos preferem | Probabilidades calibradas |
| Ponto forte | Conversar, explicar, raciocinar, gerar | Classificar, pontuar, rotear, verificar |
| Custo por chamada | Maior, cresce com o tamanho da resposta | Baixo, sem custo de saída |
| Tamanho da resposta | Pode ser longo | Compacto |
Isso não significa que o JEV substitua os LLMs. Ele não conversa, não escreve código, não explica o próprio raciocínio e não planeja tarefas longas. São arquiteturas desenhadas para problemas diferentes. E, como se verá adiante, o maior potencial pode estar na combinação das duas.
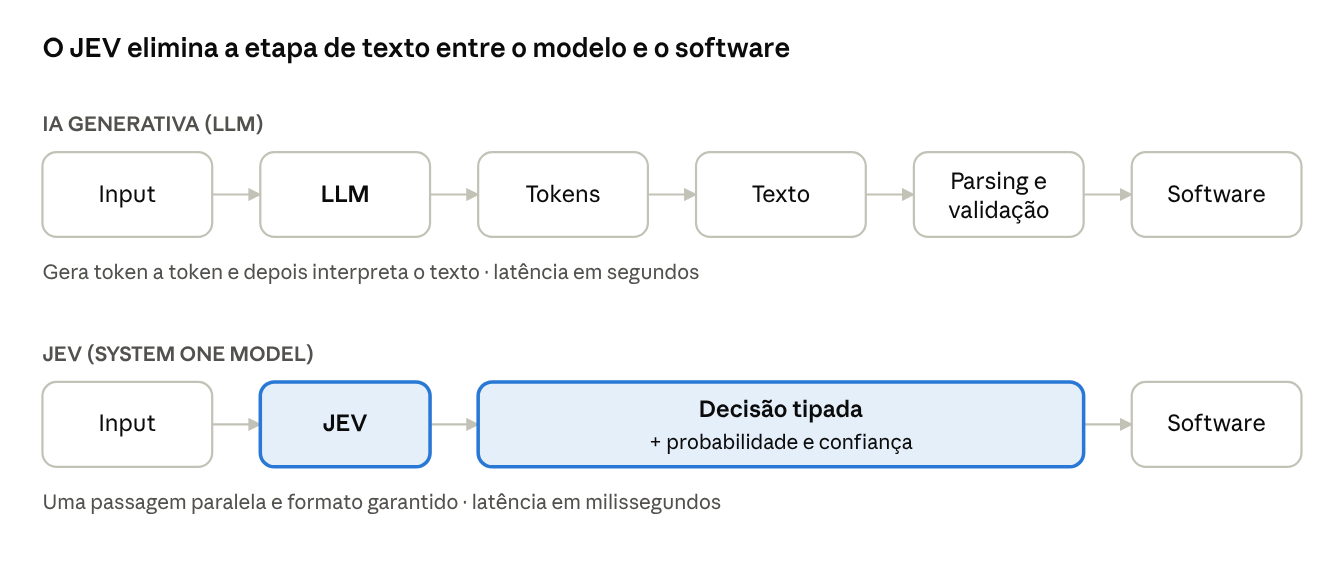
No fluxo generativo, a decisão só chega ao software depois de virar texto e ser interpretada; no JEV, ela já nasce no formato que o código consome.
A ideia por trás dos System One Models
A TypeSafe declara abertamente a inspiração: o nome da categoria vem da distinção de Kahneman entre o pensamento rápido e intuitivo do Sistema 1 e o raciocínio lento e deliberado do Sistema 2. Aplicada à arquitetura de IA, a divisão fica assim:
Sistema 2 (LLMs)          Sistema 1 (System One Models)
→ raciocinar              → reconhecer
→ planejar                → classificar
→ explicar                → decidir
→ gerar                   → encaminhar
A tese é que a IA avançou muito no Sistema 2, mas pouco no Sistema 1 como infraestrutura de software. Almeida abriu o anúncio do JEV com uma provocação: se os modelos são super-humanos em conversa há anos, onde está toda a automação? A resposta da empresa é que automação confiável exige outra interface: decisões tipadas, rápidas e acompanhadas de um grau de confiança que o código possa usar.
Há uma ironia que a própria TypeSafe reconhece. Na obra de Kahneman, o Sistema 1 é justamente a fonte dos vieses e dos erros rápidos. No texto de lançamento, a empresa admite que "pensamento de Sistema 1" carrega a conotação de algo propenso a erro, mas afirma que System One Models podem ser tornados mais confiáveis que as alternativas, e promete explicar o porquê no futuro. Por ora, trata-se de uma afirmação a ser verificada, não de um fato estabelecido.
A analogia também ajuda a entender o que o JEV não é. Assim como ninguém pede ao Sistema 1 para redigir um contrato, não faz sentido pedir ao JEV para escrever um relatório. E assim como uma pessoa experiente sabe quando parar e pensar devagar, uma boa arquitetura precisa saber quando uma decisão rápida não basta e acionar o Sistema 2.
Como o JEV funciona?
Uma requisição ao JEV tem duas partes: o estado (o contexto a ser avaliado) e as perguntas (as decisões a tomar sobre esse contexto). O modelo avalia todas as perguntas ao mesmo tempo, em paralelo, e devolve uma resposta estruturada para cada uma. A TypeSafe informa tempos de resposta de ponta a ponta entre 70 e 500 milissegundos.
Cada pergunta usa uma de três primitivas:
| Primitiva | O que faz | O que devolve | Exemplo de pergunta |
|---|---|---|---|
| Choice | Escolhe uma opção entre alternativas definidas (até 255) | Opção escolhida, probabilidade de cada opção e confiança | Para qual fila este ticket vai: Financeiro, Técnico ou Comercial? |
| Score | Avalia o estado em uma escala ordenada | Nível atribuído, probabilidade de cada nível e confiança | Qual o nível de urgência, de 1 a 5? |
| Noul | Estima se uma afirmação é verdadeira | Probabilidade entre 0 e 1 | "O cliente está ameaçando cancelar" é verdade? |
Um exemplo ilustrativo ajuda a visualizar. Imagine um e-commerce que recebe milhares de tickets de atendimento por dia. Um único ticket pode gerar quatro perguntas simultâneas:
ESTADO
"Pedido #88412 chegou com a tela quebrada. É a segunda vez.
 Se não resolverem até sexta, vou abrir reclamação no Procon."

PERGUNTAS                                RESPOSTA DO JEV
Choice  → categoria?                     Troca/Defeito   (p = 0,94)
Score   → urgência (1–5)?                 4              (p = 0,71)
Noul    → risco de reclamação formal?    0,88
Noul    → cliente recorrente com problema? 0,91
Exemplo didático, com valores hipotéticos; não reproduz a sintaxe exata da API.
O software, então, transforma essas respostas em ação: abre a troca automaticamente, marca o ticket como prioritário e aciona a equipe de retenção. Nenhuma linha de texto foi gerada, e nenhum parsing foi necessário.
Como acessar
O JEV é consumido por uma API HTTP da TypeSafe (rota jev-latest, que hoje aponta para a versão jev-1.13.0), com SDKs oficiais em Python e JavaScript. O modelo também está disponível no Vercel AI Gateway e ganhou integração com o LangChain. Um detalhe relevante para ambientes corporativos: como o alias jev-latest muda a cada nova versão, as respostas podem mudar sem aviso. Em produção, o recomendado é fixar a versão.
Há ainda um ponto de arquitetura que costuma passar despercebido: o JEV não tem conhecimento do mundo além do estado que recebe. Quem monta o estado decide o que o modelo pode saber. Isso torna a engenharia de contexto (selecionar, limpar e estruturar a informação certa) tão importante quanto o modelo em si.
O diferencial mais importante: decisões probabilísticas
Se o formato tipado resolve o problema de integração, é a probabilidade que resolve o problema de automação. A TypeSafe resume bem o dilema: se um modelo acerta uma tarefa em 95% das vezes, mas não sinaliza quando está nos 5% restantes, essa tarefa não pode ser automatizada com segurança.
Um modelo calibrado é aquele cuja confiança corresponde à taxa real de acerto: entre todas as decisões tomadas com 80% de probabilidade, cerca de 80% devem estar corretas. Com essa propriedade, a probabilidade deixa de ser um número decorativo e passa a ser uma alavanca de política de negócio:
Fraude?
SIM → 97%
NÃO →  3%

Política:
> 95%    → automatizar a decisão
70–95%   → solicitar evidência adicional
< 70%    → encaminhar para revisão humana
Para um banco, isso significa bloquear automaticamente as transações claramente fraudulentas, pedir uma confirmação ao cliente nos casos intermediários e reservar os analistas para a zona cinzenta. Para uma seguradora, significa aprovar sinistros simples em segundos e concentrar a perícia onde ela gera valor. O limiar deixa de ser uma decisão técnica e passa a ser uma decisão de apetite a risco.
O que os testes independentes mostram até agora
A calibração é a promessa central do JEV e também o ponto em que a evidência independente é mais mista. Nas duas semanas após o lançamento, desenvolvedores publicaram dezenas de avaliações no GitHub:
- Em um teste com 8.801 exemplos rotulados de sentimento, as probabilidades brutas da primitiva Noul se mostraram superconfiantes (erro de calibração, ECE, de 0,117); após um ajuste simples de regressão isotônica, o erro caiu para 0,008 (AnthusAI/Jev-Calibration).
- Em uma base pública de perguntas (OpenBookQA), um teste independente reportou 94,2% de acurácia com calibração quase perfeita. Em uma tarefa inédita de priorização com regras ocultas, porém, a acurácia caiu para 44,7%, com confiança média de 0,74 (scienthoon/jev-ood-calibration).
- Uma auditoria com cerca de 7 mil chamadas encontrou o modelo subconfiante em um conjunto de dados e superconfiante em outro, e observou que a TypeSafe não publica curvas de confiabilidade nem documenta como o campo de confiança é calculado (jujumilk3/jev-calibration-audit).
A leitura para empresas é direta: probabilidade não é garantia de acerto. A qualidade da calibração precisa ser medida com dados reais de cada contexto antes de definir qualquer limiar de automação. Essa é uma recomendação que a própria documentação da TypeSafe faz ao afirmar que o limiar ideal depende do domínio.
"JEV não alucina?" A resposta é mais complexa
No lançamento, a TypeSafe afirmou que o JEV não pode alucinar. A afirmação é verdadeira em um sentido específico e enganosa se lida de forma ampla. Para entender por quê, é preciso separar dois tipos de falha.
Alucinação textual é quando o modelo inventa algo fora do universo esperado: cita um artigo de lei que não existe, devolve uma categoria que não está na lista ou chama uma ferramenta inexistente. Como as respostas do JEV são definidas antes da chamada, esse tipo de falha é impossível por construção. A empresa reconhece que seu "0% de alucinação" não é um número medido, mas uma consequência matemática do formato.
Erro de decisão é outra coisa: o modelo escolhe uma opção válida, mas errada.
Resposta do JEV:   Fraude = 97%
Realidade:         a transação era legítima
O formato está perfeito; o julgamento, não. A garantia do JEV é sobre a forma da saída, não sobre o acerto, ponto destacado tanto pela Alura quanto pelo TechTudo na cobertura brasileira. A própria TypeSafe documenta nove modos de falha conhecidos da versão 1.13, entre eles leitura literal demais, contagem, números e datas, indireção, estado com informação que distrai e conteúdo adversarial.
A conclusão equilibrada: o JEV reduz drasticamente o espaço de respostas possíveis, mas não elimina erros de decisão. Isso já é um ganho relevante: um erro dentro de um conjunto conhecido é muito mais fácil de monitorar, medir e conter do que uma resposta imprevisível. Mas não dispensa avaliação, monitoramento e governança.
JEV é mais barato e mais rápido que um LLM?
Sim, segundo todas as medições disponíveis, mas a magnitude da vantagem depende de quem mede. Esta seção separa deliberadamente os números divulgados pela TypeSafe dos resultados de avaliações independentes.
Segundo a TypeSafe
| Dimensão | JEV | LLMs de fronteira (referência da TypeSafe) |
|---|---|---|
| Preço de entrada | US$ 0,042 por milhão de tokens (US$ 42 por bilhão) | US$ 0,20 a US$ 10 por milhão de tokens |
| Preço de saída | Gratuito | Cerca de 5× o preço de entrada |
| Latência ponta a ponta | 70 a 500 ms | 3 a 329 segundos |
| Ganho em workflows próprios | Até 193,6× mais rápido e 444,6× mais barato | Base de comparação |
Em inteligência, a TypeSafe afirma que o JEV atinge nível semelhante ao dos LLMs em tarefas de Sistema 1. Na avaliação de quatro workflows publicada pela empresa, o JEV marcou 67,8% de concordância com a referência, praticamente empatado com o GPT-5.6 Terra (67,9%) e atrás do GPT-5.6 Sol (74,1%) e do Claude Opus 5 (73,1%), a cerca de 1/200 do custo e 1/50 da latência, segundo um guia prático publicado no DEV Community.
Vale registrar a transparência da empresa sobre as próprias ressalvas, publicadas no texto de lançamento: os workflows foram escritos pela equipe de capacidades do modelo, o que pode introduzir viés; a "resposta correta" é a média de dois modelos de fronteira (GPT-6 Astra e Claude Fable 5.1), e não um gabarito humano; os ganhos de 193,6× e 444,6× tendem a estar no topo do que se verá no mundo real; e a TypeSafe diz não conseguir provar que o preço atual não é subsidiado.
Em avaliações independentes
Os testes de terceiros confirmam a direção, mas não a escala. A análise mais cuidadosa encontrada pelo blog AgentConn mediu o JEV cerca de 2,9× mais rápido e 12× mais barato que as alternativas; outras medições independentes de latência variam entre 2,9× e 18×. Um levantamento dos primeiros oito dias de testes, publicado no DEV Community, concluiu que a acurácia do JEV fica no nível de LLMs de preço intermediário (72,5% contra 74,5% a 76,0% em um estudo com seis modelos) e atrás dos modelos de fronteira.
O retrato, portanto, é mais sutil que a manchete: o JEV é de fato mais rápido e mais barato, e isso se sustenta fora dos testes da empresa, mas a vantagem medida por terceiros é de uma a quase duas ordens de grandeza menor que o número de marketing. Para decisões de Sistema 1 executadas milhões de vezes por mês, mesmo 10× de economia pode mudar a viabilidade de um caso de uso.
JEV vs GPT, Claude e Gemini
A comparação mais útil não é "quem é melhor", mas "qual problema cada arquitetura foi desenhada para resolver". A tabela abaixo é conceitual, não um ranking:
| Característica | LLMs (GPT, Claude, Gemini) | JEV |
|---|---|---|
| Geração de texto | Forte | Não é o objetivo |
| Raciocínio em múltiplas etapas | Forte | Limitado a cada decisão |
| Decisão estruturada | Possível, com parsing e validação | Nativa |
| Probabilidade | Nem sempre disponível ou calibrada | Parte central da proposta |
| Latência | Segundos | Milissegundos |
| Conversação | Sim | Não |
| Papel em AI Agents | Planejar, interpretar, gerar | Decidir cada passo, validar, escalar |
| Custo em escala de microdecisões | Alto | Baixo (é a tese central) |
Nenhuma das duas arquiteturas é superior em termos absolutos. Um LLM continua indispensável para interpretar um pedido ambíguo, redigir uma resposta ao cliente ou decompor um problema novo. O JEV faz sentido quando a mesma pergunta estruturada se repete em volume, com necessidade de resposta rápida e de um sinal de confiança.
JEV + LLM: o verdadeiro potencial pode estar na combinação
A visão mais promissora não opõe os dois modelos: coloca cada um no papel em que é mais eficiente. O LLM atua como Sistema 2, interpretando o problema e planejando a execução. O JEV atua como Sistema 1, tomando dezenas de microdecisões ao longo do workflow e devolvendo ao LLM, ou a um humano, apenas os casos em que a confiança é baixa.
Pense em um fluxo de análise de crédito. O LLM lê a documentação do cliente, identifica o que está faltando e redige o parecer. Entre um passo e outro, o JEV responde perguntas como "o comprovante de renda é válido?", "há inconsistência entre os documentos?" e "o caso exige analista?". O LLM é chamado poucas vezes; o JEV, muitas. O custo total cai, a latência cai e cada decisão intermediária passa a ter uma probabilidade auditável.
A reportagem da Exame descreve a mesma divisão de trabalho: uma camada de decisão ágil cuidando do roteamento de dados operacionais, enquanto modelos conversacionais seguem dedicados à criação de conteúdo e ao planejamento analítico.
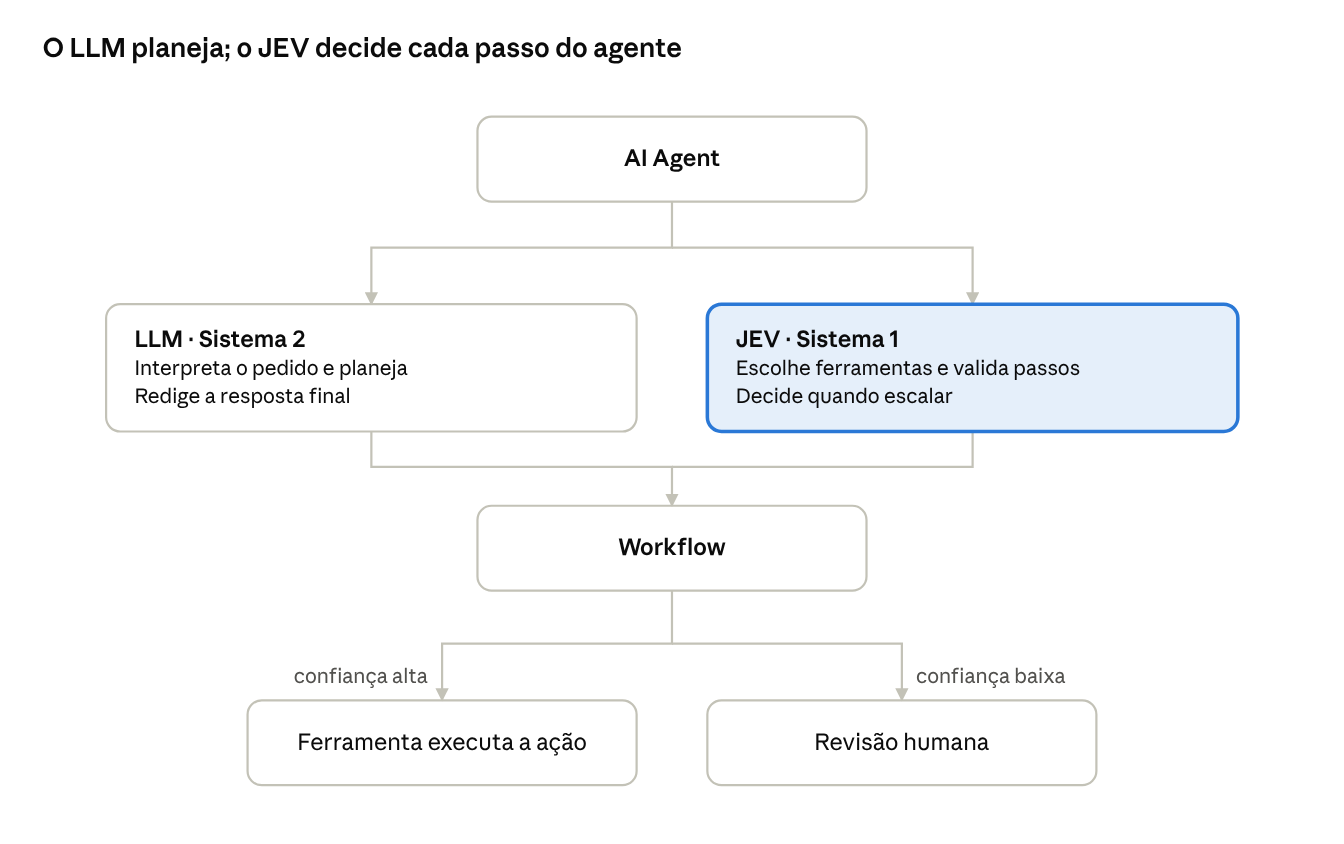
O LLM é chamado poucas vezes para interpretar e redigir; o JEV decide cada passo e só envia ao humano o que ficou abaixo do limiar de confiança.
JEV e AI Agents: o sistema nervoso dos agentes
Se um agente já consegue raciocinar, por que precisaria do JEV? Porque raciocinar é só uma parte do trabalho. Durante a execução de uma tarefa, um agente toma dezenas (às vezes centenas) de microdecisões:
Qual ferramenta usar?           → Choice
Este documento é relevante?     → Noul
Preciso de mais informação?     → Noul
Qual o risco desta ação?        → Score
Posso executar sem aprovação?   → Noul
Preciso escalar para um humano? → Noul
Hoje, cada uma dessas perguntas costuma virar uma chamada completa a um LLM, com segundos de espera e custo de geração. Em um agente que executa 50 passos, a soma se torna o gargalo. É nesse ponto que a metáfora de Kahneman fica concreta: o LLM funciona como o córtex que planeja, e o JEV como o sistema nervoso que reage, conduzindo sinais rápidos, decidindo reflexos e acionando o raciocínio deliberado apenas quando necessário. A expressão é uma leitura editorial desta análise, não uma categoria de mercado estabelecida.
Os primeiros sinais práticos vêm de parceiros e demonstrações. Segundo a MarkTechPost, um agente de navegação da Browser Use com JEV concluiu uma busca de passagens Zurique–Londres no Google Flights em 7,1 segundos, e um agente móvel da Droidrun operou o aplicativo da Uber em um celular Android real, com 9 ações em cerca de 21 segundos. A própria TypeSafe demonstrou o JEV jogando Doom a cerca de 10 decisões por segundo, a um custo estimado de US$ 7 por hora, e escolhendo entre centenas de links por passo em um jogo de navegação pela Wikipedia. São demonstrações controladas, não implantações empresariais, mas ilustram o tipo de loop que a arquitetura habilita.
Há também um uso menos visível e talvez mais valioso: verificação. A TypeSafe posiciona o JEV para pontuar, julgar e aplicar guardrails sobre prompts, cadeias de raciocínio e saídas de LLMs, incluindo a detecção de tentativas de jailbreak. Em arquiteturas agênticas, um verificador barato e rápido que roda em todos os passos pode ser a diferença entre um agente em demonstração e um agente em produção.
Onde o JEV pode ser utilizado?
Entre os exemplos apresentados pela TypeSafe estão processamento de notas fiscais, atendimento ao cliente, análise de incidentes de segurança e monitoramento de agentes de IA, segundo a Fast Company Brasil. O denominador comum é sempre o mesmo: uma pergunta estruturada, repetida em volume, cuja resposta alimenta uma ação de software. A tabela abaixo organiza oito frentes com potencial em ambientes corporativos:
| Frente | Microdecisões típicas | Exemplo empresarial |
|---|---|---|
| Crédito | Risco, aprovação, inconsistência documental, necessidade de revisão | Banco que faz a triagem de propostas antes da análise humana |
| Fraude | Detecção, classificação do tipo, escalonamento | Fintech que decide em milissegundos se bloqueia, confirma ou libera um Pix |
| Atendimento | Intenção, sentimento, prioridade, roteamento | Varejista que direciona milhares de tickets por dia para a fila certa |
| Compliance | Identificação de risco, aderência a políticas, documentação obrigatória | Seguradora que verifica se cada contrato traz as cláusulas exigidas |
| AI Agents | Escolha de ferramenta, validação de passo, guardrails, escalonamento | Agente de back-office que só executa ações com confiança acima do limiar |
| FinOps de IA | Complexidade da tarefa, escolha do modelo, roteamento por custo | Plataforma que decide se uma pergunta vai para um modelo pequeno ou de fronteira |
| Operações | Aprovação, inspeção de qualidade, anomalias | Indústria que classifica registros de manutenção e sinaliza falhas recorrentes |
| Documentos | Classificação, relevância, validação de campos | Empresa que processa notas fiscais e contratos em grande volume |
Duas frentes merecem destaque. A primeira é FinOps de IA: usar um modelo de decisão barato para escolher qual LLM deve responder cada pergunta pode reduzir o custo total de uma plataforma de IA sem sacrificar qualidade onde ela importa. A segunda é o processamento de grandes volumes de dados: a TypeSafe menciona o uso do JEV em rotinas de map-reduce para transformar grandes bases não estruturadas em atributos e sinais, um caso que conversa diretamente com plataformas de dados como Snowflake e Databricks, onde classificar milhões de registros com LLMs ainda é proibitivo.
Onde o JEV ainda precisa provar seu valor
Nenhuma análise séria sobre uma tecnologia com poucas semanas de vida está completa sem as limitações. Estas são as mais relevantes para quem avalia o JEV em contexto empresarial:
- Modelo muito novo. O acesso ainda é antecipado, e o histórico de operação em produção é de semanas, não de anos.
- Evidência majoritariamente do fabricante. Os benchmarks de inteligência, custo e velocidade mais citados foram produzidos pela própria TypeSafe, e a empresa optou por não publicar resultados em benchmarks públicos.
- Pouca transparência técnica. Não há artigo técnico, pesos nem arquitetura detalhada. A empresa descreve o modelo como baseado em transformers e treinado exclusivamente com dados sintéticos; observadores externos sugerem que ele pode ter sido construído sobre um LLM de pesos abertos.
- Calibração fora da distribuição. Treinado com dados sintéticos, o modelo ainda precisa demonstrar que suas probabilidades se mantêm calibradas em dados reais de produção. Os testes independentes citados acima mostram resultados divergentes.
- Modos de falha conhecidos. Contagem, números e datas, leitura literal, indireção, contexto com ruído e conteúdo adversarial estão entre as fraquezas documentadas pela própria TypeSafe.
- Sem conhecimento do mundo. O JEV só sabe o que está no estado enviado. Contexto incompleto gera decisões ruins, com a mesma confiança aparente.
- Versionamento. O alias jev-latest muda silenciosamente a cada versão, o que pode alterar decisões em produção.
- Soberania e LGPD. O serviço opera a partir da costa oeste dos Estados Unidos. Para dados pessoais ou sensíveis de clientes brasileiros, residência de dados, bases legais e contratos precisam ser avaliados antes de qualquer piloto.
- Não substitui LLMs nem governança. O JEV não explica suas decisões em linguagem natural, o que exige outras camadas para explicabilidade, auditoria e observabilidade.
Nenhum desses pontos invalida a proposta. Eles indicam, sim, que a adoção responsável passa por prova de conceito com dados reais, calibração por domínio e um desenho claro de quando a decisão rápida deve dar lugar ao raciocínio ou ao humano.
JEV e Decision Intelligence
Decision Intelligence é a disciplina que trata a decisão como o produto final de dados e modelos, e não o relatório ou o dashboard. Sob essa lente, o JEV pode ser lido como uma camada de infraestrutura de decisão: o ponto em que o contexto vira escolha, e a escolha vira ação.
Dados → Contexto → IA → Decisão → AçãoPara empresas que já investiram em plataformas de dados, camadas semânticas e grafos de conhecimento, isso tem uma implicação prática. O valor de um modelo de decisão depende inteiramente da qualidade do estado que ele recebe. Quanto mais governado, atualizado e bem estruturado for o contexto corporativo, mais confiáveis serão as microdecisões tomadas sobre ele.
O que o JEV pode significar para o futuro da IA?
Até agora, a evolução da IA esteve concentrada na capacidade de gerar conteúdo. O JEV aponta para outra direção: tornar a inteligência uma infraestrutura invisível dentro do software, chamada como uma função qualquer.
Hoje:              Software + Regras + LLM
Possível evolução: Software + Regras + LLM + Modelos de decisão
Se o paradoxo de Jevons se confirmar para a inteligência artificial, a queda no custo por decisão não reduzirá o gasto com IA: multiplicará o número de decisões automatizadas. Regras de negócio frágeis, escritas à mão em cadeias de if-else, poderiam dar lugar ao que a TypeSafe chama de smart if-statements: condicionais que entendem linguagem, mas se comportam como código.
JEV pode criar uma nova categoria de IA?
Ainda é cedo para responder. Há pelo menos três hipóteses plausíveis:
- Uma nova categoria se consolida. System One Models se tornam uma classe própria de modelos, com múltiplos fornecedores, benchmarks específicos e espaço dedicado nas arquiteturas corporativas.
- A ideia é absorvida pelos grandes LLMs. Os laboratórios de fronteira incorporam modos de decisão tipada, paralela e calibrada aos seus próprios modelos, e a categoria deixa de existir como produto separado.
- Surge uma camada de infraestrutura. A decisão rápida vira um componente padrão do stack de IA, como hoje são os bancos vetoriais ou os gateways de modelos, com o JEV como um entre vários provedores.
A existência de alternativas abertas já sugere que a ideia não ficará restrita a um fornecedor: poucos dias após o lançamento, desenvolvedores reproduziram a mesma interface com pequenos modelos abertos, ainda que com acurácia inferior. O que já parece claro é que o problema de transformar IA em decisões de software merece uma arquitetura própria.
O que empresas deveriam observar ao avaliar o JEV
Para líderes de Data & AI que consideram um piloto, a avaliação deve ir além da acurácia. Os critérios abaixo ajudam a estruturar uma prova de conceito:
| Critério | Pergunta a responder no piloto |
|---|---|
| Acurácia | Qual a taxa de acerto com dados reais do meu domínio, e não em benchmarks do fornecedor? |
| Calibração | As probabilidades correspondem à taxa real de acerto? Precisam de recalibração? |
| Latência | O tempo de resposta medido a partir do Brasil atende ao SLA do processo? |
| Custo | Qual o custo por decisão comparado ao LLM ou à regra atual, considerando o volume real? |
| Escalonamento | Qual limiar de confiança separa automação, pedido de evidência e revisão humana? |
| Observabilidade | Cada decisão é registrada com estado, versão do modelo e probabilidade? |
| Drift | Como detectar quando a distribuição dos dados muda e a calibração se degrada? |
| Segurança | Como o modelo reage a conteúdo adversarial inserido no estado? |
| Explicabilidade | Como justificar uma decisão para auditoria, cliente ou regulador? |
| Privacidade e LGPD | Onde os dados são processados, e sob qual base legal? |
| Integração | O JEV se encaixa no gateway, na orquestração e na plataforma de dados existentes? |
| ROI | Quantas decisões passam a ser automatizadas, e quanto isso vale para o negócio? |
JEV em 5 pontos
- O que é? Um modelo de IA orientado a decisões, e não à geração de texto.
- Quem criou? A TypeSafe AI, fundada por Diogo Almeida, ex-pesquisador da OpenAI. Lançado em 15 de setembro de 2026.
- Qual a diferença? Em vez de texto, devolve decisões tipadas, com probabilidade e confiança, em milissegundos.
- Para que serve? Classificação, scoring, roteamento, verificação, guardrails e microdecisões em workflows e AI Agents.
- Por que importa? Porque pode tornar a inteligência artificial mais barata, rápida e integrada ao software, desde que a calibração se confirme em dados reais.
Perguntas frequentes sobre o JEV
Perguntas frequentes
O que é JEV?
É um modelo de inteligência artificial da TypeSafe AI que transforma contexto em decisões estruturadas e probabilísticas, em vez de gerar texto. É o primeiro modelo público da categoria que a empresa chama de System One Models.
Quem criou o JEV?
A TypeSafe AI, startup de São Francisco fundada em 2024 por Diogo Almeida, Erik Gafni e Sasha Sheng. Almeida trabalhou na OpenAI em pesquisas ligadas ao RLHF e ao ChatGPT.
O que são System One Models?
É o nome que a TypeSafe deu a modelos construídos para decisões rápidas e estruturadas que o software consome diretamente. O termo faz referência ao Sistema 1 descrito por Daniel Kahneman: o modo de pensamento rápido, automático e intuitivo.
Qual a diferença entre JEV e um LLM?
Um LLM gera texto token a token. O JEV devolve, em uma única passagem paralela, uma resposta escolhida entre opções definidas previamente, com probabilidade e confiança.
O JEV substitui o GPT, o Claude ou o Gemini?
Não. O JEV não conversa, não escreve e não raciocina em múltiplas etapas. Ele complementa os LLMs, assumindo microdecisões repetitivas enquanto os LLMs cuidam de interpretação, planejamento e geração.
O JEV gera texto?
Não. Suas saídas são sempre valores tipados: uma opção escolhida, um nível em uma escala ou uma probabilidade entre 0 e 1.
O JEV pode ser usado em AI Agents?
Sim. É um dos usos mais promissores: escolher ferramentas, validar passos, aplicar guardrails e decidir quando escalar para um humano.
O JEV pode cometer erros?
Sim. O formato da resposta é garantido, mas o julgamento pode estar errado. Por isso a calibração precisa ser validada com dados reais de cada aplicação.
O JEV é open source?
Não. É um modelo proprietário, acessado por API, sem pesos públicos.
Quanto custa o JEV?
No lançamento, a TypeSafe divulgou US$ 0,042 por milhão de tokens de entrada, sem cobrança pelos tokens de saída. Preços podem mudar; consulte o site oficial.
Como usar a API do JEV?
Por meio da API HTTP da TypeSafe, com SDKs em Python e JavaScript, após liberar o acesso antecipado. O modelo também está disponível no Vercel AI Gateway e integrado ao LangChain. A documentação está em docs.typesafe.ai.
O JEV pode ser usado em empresas?
Sim, mas recomenda-se começar por uma prova de conceito com dados reais, limiares de confiança definidos e avaliação de privacidade e LGPD, dado que o modelo é recente e processado nos Estados Unidos.
Conclusão: talvez uma nova camada da arquitetura de IA
Daniel Kahneman mostrou que a mente humana não depende de um único modo de pensar, mas da combinação entre um sistema rápido, que resolve a maior parte do dia, e um sistema lento, reservado ao que exige reflexão. A inteligência artificial corporativa talvez esteja chegando ao mesmo ponto. Durante anos, a indústria investiu quase tudo no Sistema 2: modelos que escrevem, explicam e raciocinam. O JEV é uma das primeiras tentativas sérias de construir o Sistema 1 como infraestrutura de software.
É cedo para afirmar que o JEV é o futuro. As promessas de custo e velocidade se confirmam na direção, mas não na magnitude anunciada, e a calibração, seu principal diferencial, ainda precisa ser provada em dados reais. Mesmo assim, a pergunta que ele coloca sobre a mesa é difícil de ignorar: quantas decisões dentro da sua empresa estão sendo tomadas hoje por regras frágeis, por pessoas sobrecarregadas ou por LLMs caros demais para a tarefa?
A resposta a essa pergunta é o verdadeiro ponto de partida. Mais do que escolher um modelo, trata-se de mapear as decisões, entender o contexto de que cada uma depende e desenhar quando a IA age, quando pede ajuda e quando um humano assume.
A primeira geração de IA ensinou máquinas a gerar. A próxima pode ensiná-las a decidir.
Quer entender como essa nova arquitetura pode ser aplicada a uma solução de Enterprise AI? A triggo.ai acompanha tecnologias emergentes de Data & AI e desenvolve arquiteturas para transformar dados, modelos e agentes em aplicações de negócio. Conheça a visão da triggo.ai sobre a próxima geração de Enterprise AI.
Perguntas frequentes
O que é JEV?
É um modelo de inteligência artificial da TypeSafe AI que transforma contexto em decisões estruturadas e probabilísticas, em vez de gerar texto. É o primeiro modelo público da categoria que a empresa chama de System One Models.
Quem criou o JEV?
A TypeSafe AI, startup de São Francisco fundada em 2024 por Diogo Almeida, Erik Gafni e Sasha Sheng. Almeida trabalhou na OpenAI em pesquisas ligadas ao RLHF e ao ChatGPT.
O que são System One Models?
É o nome que a TypeSafe deu a modelos construídos para decisões rápidas e estruturadas que o software consome diretamente. O termo faz referência ao Sistema 1 descrito por Daniel Kahneman: o modo de pensamento rápido, automático e intuitivo.
Qual a diferença entre JEV e um LLM?
Um LLM gera texto token a token. O JEV devolve, em uma única passagem paralela, uma resposta escolhida entre opções definidas previamente, com probabilidade e confiança.
O JEV substitui o GPT, o Claude ou o Gemini?
Não. O JEV não conversa, não escreve e não raciocina em múltiplas etapas. Ele complementa os LLMs, assumindo microdecisões repetitivas enquanto os LLMs cuidam de interpretação, planejamento e geração.
O JEV gera texto?
Não. Suas saídas são sempre valores tipados: uma opção escolhida, um nível em uma escala ou uma probabilidade entre 0 e 1.
O JEV pode ser usado em AI Agents?
Sim. É um dos usos mais promissores: escolher ferramentas, validar passos, aplicar guardrails e decidir quando escalar para um humano.
O JEV pode cometer erros?
Sim. O formato da resposta é garantido, mas o julgamento pode estar errado. Por isso a calibração precisa ser validada com dados reais de cada aplicação.
O JEV é open source?
Não. É um modelo proprietário, acessado por API, sem pesos públicos.
Quanto custa o JEV?
No lançamento, a TypeSafe divulgou US$ 0,042 por milhão de tokens de entrada, sem cobrança pelos tokens de saída. Preços podem mudar; consulte o site oficial.
Como usar a API do JEV?
Por meio da API HTTP da TypeSafe, com SDKs em Python e JavaScript, após liberar o acesso antecipado. O modelo também está disponível no Vercel AI Gateway e integrado ao LangChain. A documentação está em docs.typesafe.ai.
O JEV pode ser usado em empresas?
Sim, mas recomenda-se começar por uma prova de conceito com dados reais, limiares de confiança definidos e avaliação de privacidade e LGPD, dado que o modelo é recente e processado nos Estados Unidos.
Receba conteúdos de Data & AI
Insights práticos sobre IA, Data Products e Agentes — sem spam.
triggo.ai
Soluções e Produtos de Data & AI para empresas que buscam escala e impacto real.