Neste artigo
- O paradoxo do modelo cada vez melhor
- De prompt a harness: três ondas de engenharia em torno dos LLMs
- De onde vem o termo e por que ele importa
- A anatomia de um harness: sete camadas
- O que os casos de referência ensinam
- Um mapa, não um manual
- Invariantes, não microgestão
- Separar quem faz de quem avalia
- Coleta de lixo contínua
- O peso do harness em números
- Além do código: harness para agentes de dados e de negócio
- Onde sua empresa está: um modelo de maturidade
- Um roteiro de 90 dias
- Os limites e as críticas que merecem atenção
- O harness é o ativo; o modelo é trocável
Modelos melhores não resolveram o desafio de levar agentes de IA à produção. O gargalo mudou de lugar: saiu do modelo e foi para o sistema que o envolve.
Harness é tudo o que envolve um modelo de IA para transformá-lo em um agente capaz de trabalhar de forma confiável. O modelo raciocina e decide; o harness fornece o restante: as instruções e o contexto de negócio que orientam o agente, as ferramentas e o ambiente em que ele age, os mecanismos que verificam se o resultado está correto, a memória que preserva o trabalho entre sessões e as regras de governança que limitam o que ele pode fazer. Em uma fórmula simples, agente = modelo + harness. A palavra vem do arreio usado em animais de tração, que canaliza uma força potente e imprevisível em uma direção útil. Harness engineering é a disciplina de projetar, medir e evoluir esse sistema, e ela se tornou em 2026 o principal fator de diferença entre agentes que impressionam em demonstrações e agentes que entregam resultado auditável em produção.
O paradoxo do modelo cada vez melhor
Em fevereiro de 2026, um time de três engenheiros da OpenAI relatou ter entregado, em cerca de cinco meses, um produto com aproximadamente um milhão de linhas de código sem escrever nenhuma delas manualmente. Cada linha de aplicação, teste, pipeline de CI, documentação e ferramenta interna foi produzida por agentes Codex. Foram cerca de 1.500 pull requests, uma média de 3,5 por engenheiro por dia, e o time estima ter levado um décimo do tempo que o desenvolvimento manual exigiria (OpenAI).
O dado chama atenção, mas o aspecto mais revelador do relato é outro. Segundo o próprio time, o início foi mais lento que o esperado. A causa não foi limitação do modelo, e sim um ambiente subespecificado: faltavam ferramentas, abstrações e estrutura interna para que o agente avançasse em direção a objetivos de alto nível. A principal tarefa dos engenheiros passou a ser habilitar os agentes a fazer trabalho útil.
Essa constatação ecoa a experiência de muitas empresas brasileiras nos últimos dois anos. Pilotos de agentes funcionam em demonstrações controladas e perdem consistência quando expostos a sistemas reais, dados reais e prazos reais. A reação intuitiva é esperar o próximo modelo. A evidência acumulada em 2026 aponta em outra direção: o que diferencia agentes confiáveis de agentes frágeis está, cada vez mais, fora do modelo.
A esse “fora” deu-se o nome de harness, e a disciplina de construí-lo ganhou forma rapidamente.
De prompt a harness: três ondas de engenharia em torno dos LLMs
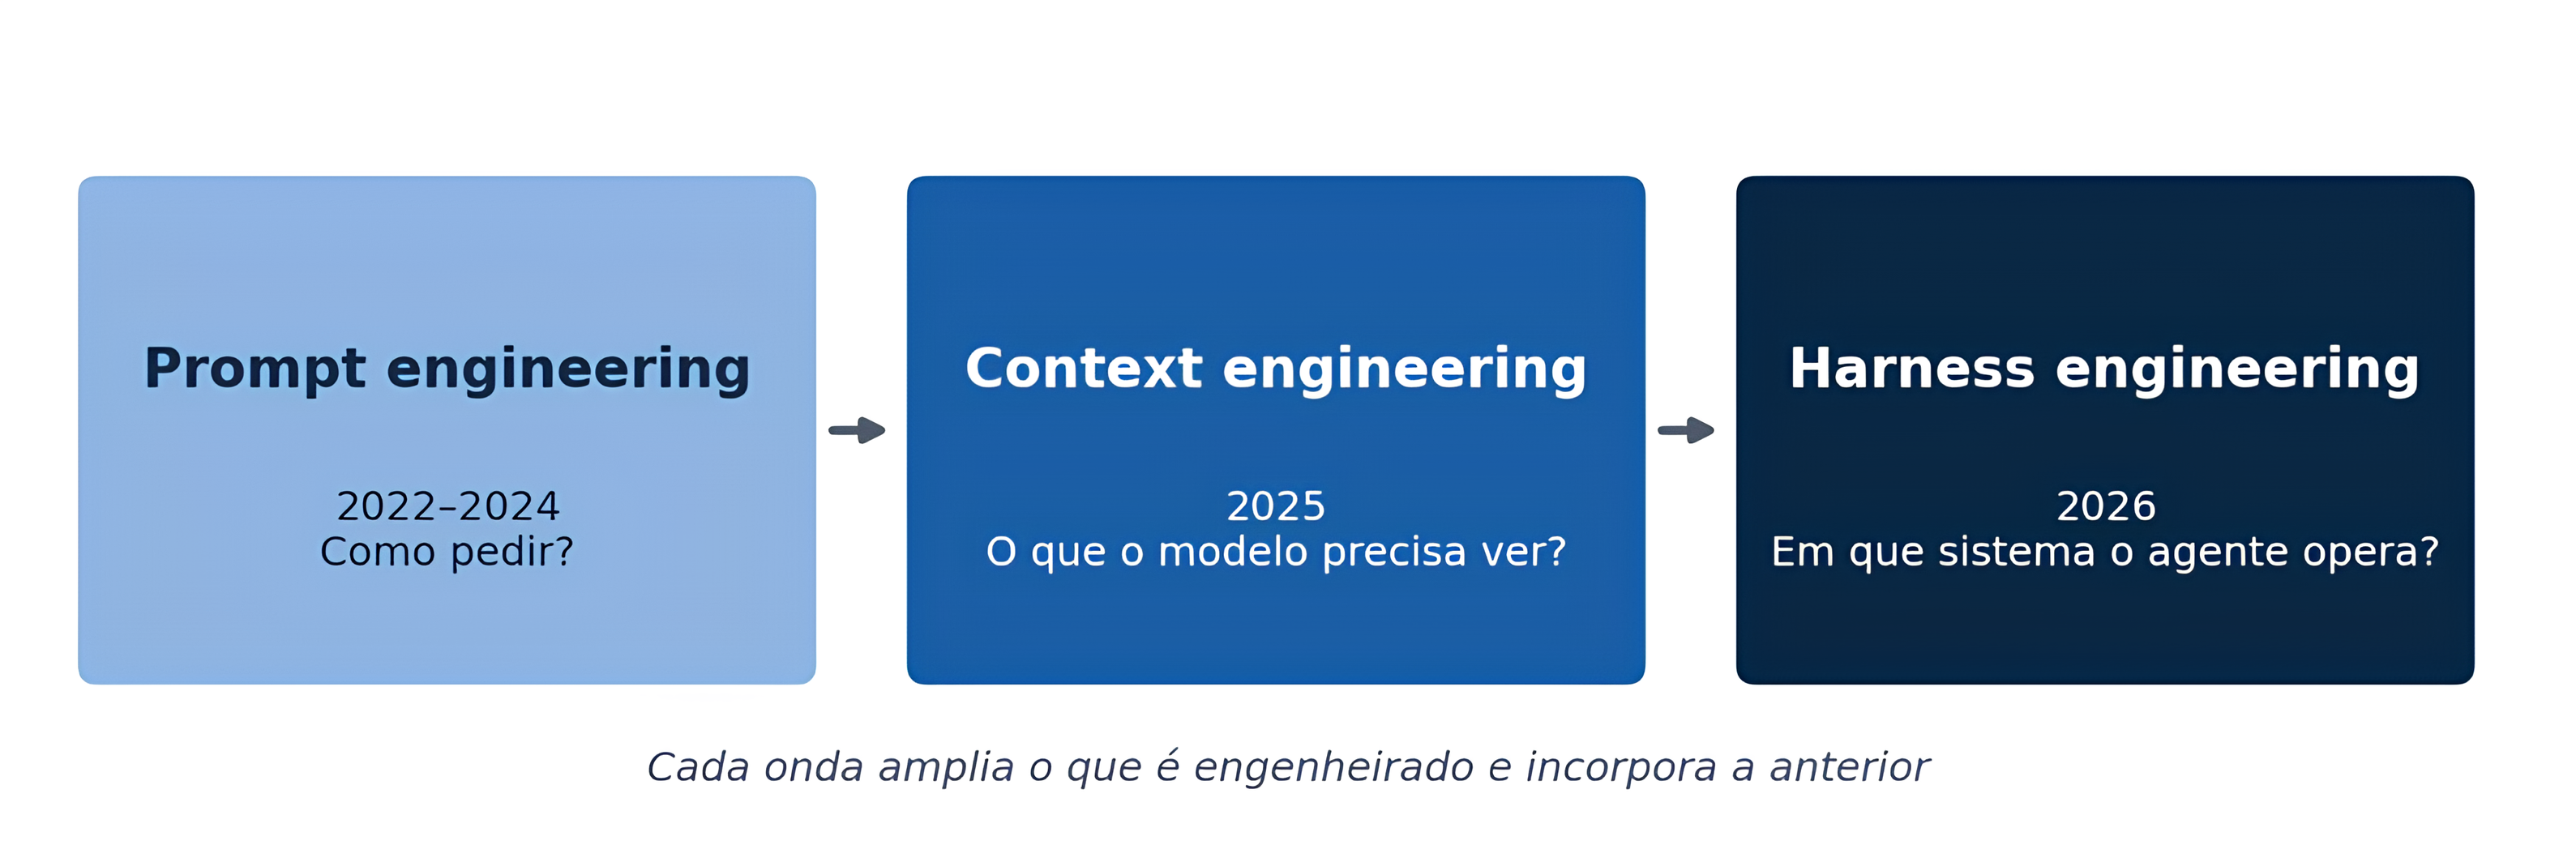
Para compreender por que o termo se consolidou tão rapidamente, é útil observar a trajetória recente da engenharia aplicada a modelos de linguagem. Ela pode ser lida como três ondas sucessivas, cada uma ampliando o que precisa ser deliberadamente projetado.
A primeira onda, entre 2022 e 2024, foi a da engenharia de prompt. A pergunta central era como pedir: que instruções, exemplos e formatos extraíam as melhores respostas de um modelo em uma interação isolada.
A segunda onda, que ganhou corpo ao longo de 2025, foi a da engenharia de contexto. Com agentes executando tarefas de múltiplas etapas, a pergunta mudou para o que o modelo precisa ver a cada momento. A janela de contexto passou a ser tratada como recurso escasso, a ser curado, comprimido e renovado. A triggo.ai já explorou esse tema em profundidade no artigo O que é Engenharia de Contexto?.
A terceira onda, em 2026, é a da engenharia de harness. A pergunta agora é mais ampla: em que sistema o agente opera, e como se sabe que ele acertou? A unidade de trabalho deixa de ser a instrução ou a janela de contexto e passa a ser o ambiente inteiro, com suas ferramentas, restrições, mecanismos de verificação, memória e governança. O foco se desloca progressivamente para fora do modelo à medida que ele se torna mais capaz.
| Disciplina | Pergunta que responde | Unidade de trabalho |
|---|---|---|
| Engenharia de prompt | Como pedir? | A instrução |
| Engenharia de contexto | O que o modelo precisa ver agora? | A janela de contexto |
| Engenharia de harness | Em que sistema o agente opera, e como se sabe que ele acertou? | O ambiente, as restrições e os loops de feedback |
É importante não ler essa sequência como substituição. Construir o harness de um agente continua exigindo boa engenharia de contexto, que por sua vez depende de bons prompts. Cada onda incorpora a anterior.
De onde vem o termo e por que ele importa
O termo foi popularizado em fevereiro de 2026 por Mitchell Hashimoto, cofundador da HashiCorp, que descreveu como etapa madura de sua adoção de IA a prática de “engenheirar o harness”: sempre que um agente comete um erro, investe-se tempo em uma solução para que ele nunca mais o repita (Hashimoto). Dias depois, a OpenAI publicou o relato mencionado acima, e em poucas semanas a expressão havia entrado no vocabulário central da engenharia de IA.
Na prática, o harness inclui prompts de sistema, ferramentas e suas descrições, infraestrutura embarcada (sistema de arquivos, sandbox, navegador), lógica de orquestração e hooks que executam ações determinísticas, como compactação de contexto ou verificação automática de código. Convém distinguir dois níveis. Há o harness embutido pelo fabricante do agente, presente em ferramentas como Claude Code ou Codex, e há o harness que cada organização constrói para seu próprio sistema, suas convenções e seu domínio. É neste segundo nível que está a maior parte do valor para as empresas, porque é nele que o conhecimento específico da organização se materializa.
Uma consequência prática dessa visão é mudar o diagnóstico de falhas. Muitas supostas falhas de modelo são, na verdade, falhas de harness: o agente esqueceu porque nada persistiu o estado correto, repetiu trabalho porque não havia registro durável de uma tentativa anterior, escolheu a ferramenta errada porque o espaço de ações estava sobrecarregado. Quando a falha é reclassificada, a solução deixa de ser “esperar um modelo melhor” e passa a ser engenharia.
A anatomia de um harness: sete camadas
Entendido o conceito, o próximo passo é decompô-lo em partes que possam ser projetadas, medidas e mantidas. A partir dos relatos públicos de quem opera agentes em escala e da experiência em projetos de dados e IA, a triggo.ai propõe uma arquitetura de referência em sete camadas.
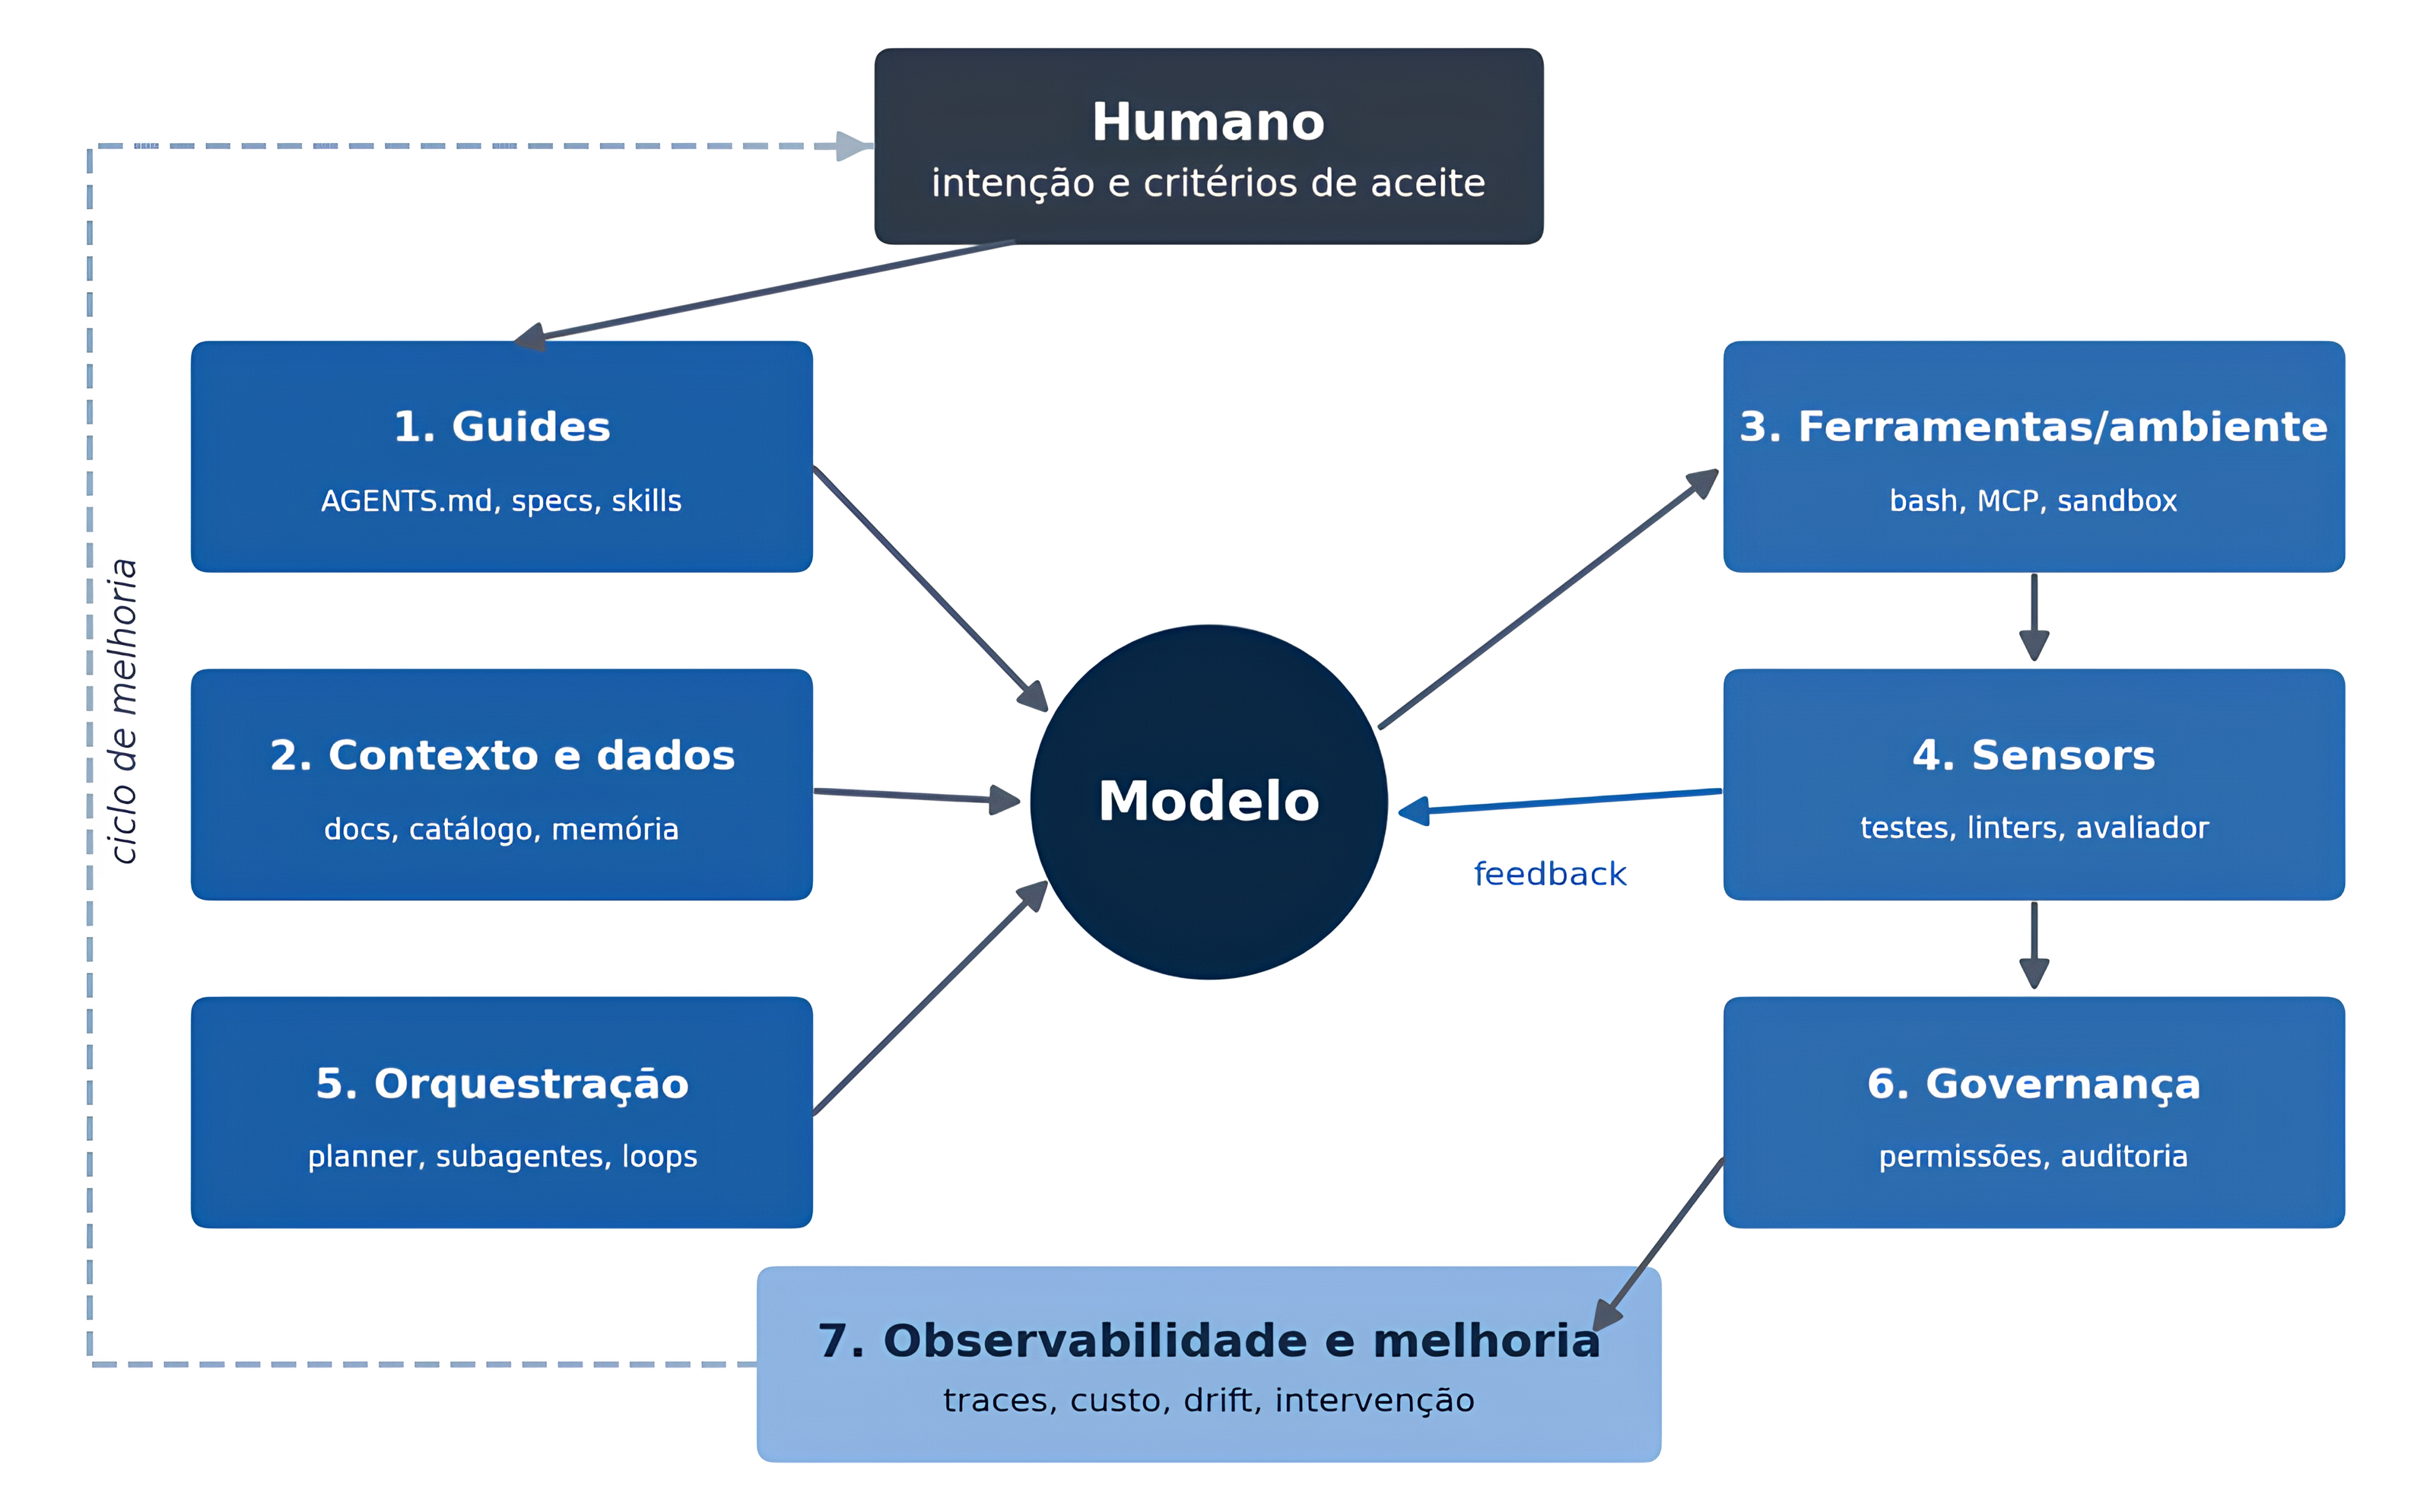
1. Guides (controles de antecipação). São os elementos que orientam o agente antes que ele aja: arquivos como AGENTS.md, documentos de arquitetura, especificações, skills e planos de execução. Sua função é aumentar a probabilidade de acerto na primeira tentativa.
2. Contexto e dados. É a camada que entrega a informação certa no momento certo: base de conhecimento versionada, memória persistente, busca, conectores via MCP e, em ambientes corporativos, catálogo, linhagem e definições de negócio. A pergunta de desenho é direta: o que o agente precisa saber que hoje vive no Slack ou na cabeça de alguém?
3. Ferramentas e ambiente. O agente precisa agir com segurança. Isso significa sistema de arquivos com versionamento, execução de código, sandbox isolado, navegador e, em casos avançados, uma pilha de observabilidade efêmera por tarefa. Dar ao agente a capacidade de escrever e executar código é um dos passos mais importantes para a autonomia, porque permite que ele crie as próprias ferramentas.
4. Sensors (controles de verificação). São os elementos que observam depois da ação e permitem autocorreção: testes, linters, verificadores de tipo, testes estruturais de arquitetura, agentes revisores e testes ponta a ponta. A pergunta central é como “pronto” é comprovado por evidência, e não por uma afirmação do modelo.
5. Orquestração. Tarefas longas não cabem em uma única janela de contexto. Esta camada decompõe o trabalho, distribui papéis (planejador, executor, avaliador), coordena subagentes e define como o estado passa de uma sessão para a seguinte.
6. Governança. Define o que o agente nunca pode fazer e quem responde quando ele erra: permissões com menor privilégio, isolamento de rede, portões de revisão humana proporcionais ao risco e trilha de auditoria.
7. Observabilidade e melhoria. Mede custo, tempo, taxa de intervenção humana e deriva de qualidade, e alimenta o ciclo de condução: o processo pelo qual o humano ajusta orientações e verificações sempre que um problema se repete.
Dois eixos atravessam essas camadas e ajudam a projetar cada controle. O primeiro é a direção: antecipação (guides) ou verificação (sensors). Isoladamente, cada uma falha. Um agente só com verificação repete os mesmos erros; um agente só com orientação codifica regras sem jamais saber se funcionaram. O segundo eixo é a natureza do controle: computacional, determinístico, rápido e barato (testes, linters, análise estática), ou inferencial, semântico, mais caro e não determinístico (revisão por LLM, o chamado LLM-as-judge). Um harness maduro usa controles computacionais sempre que possível e reserva os inferenciais para o que exige julgamento.
| Direção | Computacional | Inferencial |
|---|---|---|
| Guides (antes da ação) | Language servers, codemods, scripts de bootstrap | AGENTS.md, skills, especificações, princípios de arquitetura |
| Sensors (depois da ação) | Testes, linters, type checkers, testes estruturais | Agente revisor, LLM-as-judge, avaliador com navegador |
Um princípio atravessa todas as camadas: a conclusão de uma tarefa deve estar amarrada a evidência verificável, nunca à afirmação do próprio agente de que terminou. E toda falha deve ser diagnosticada e classificada antes de uma nova tentativa, para que o harness aprenda com ela.
O que os casos de referência ensinam
A arquitetura ganha substância quando confrontada com os relatos públicos de quem já opera harnesses em escala. Os dois mais detalhados, da OpenAI e da Anthropic, chegaram por caminhos diferentes a padrões notavelmente convergentes.
Um mapa, não um manual
A primeira lição do time da OpenAI contraria a intuição: mais instrução não produz melhor resultado. A tentativa inicial de concentrar tudo em um único AGENTS.md extenso falhou de formas previsíveis. O arquivo gigante ocupava contexto que deveria ir para a tarefa; quando tudo era marcado como importante, nada era; as regras envelheciam sem que ninguém percebesse; e não havia como verificar mecanicamente sua consistência.
A solução foi tratar o AGENTS.md como sumário: cerca de 100 linhas apontando para uma base de conhecimento estruturada em um diretório de documentação, com documentos de design, planos de execução ativos e concluídos, especificações de produto e um registro de dívida técnica. Linters e jobs de CI validam que essa base está atualizada e bem conectada, e um agente recorrente de “jardinagem de documentação” abre correções quando detecta divergência entre docs e código. O princípio subjacente é o de progressive disclosure: o agente começa por um ponto de entrada pequeno e estável e aprende onde procurar em seguida.
Por trás disso está uma constatação de alto impacto para qualquer empresa: do ponto de vista do agente, o que não está acessível em contexto simplesmente não existe. A discussão no Slack que alinhou o time sobre um padrão arquitetural, se não estiver registrada no repositório, é tão invisível para o agente quanto seria para um novo contratado três meses depois.
Invariantes, não microgestão
A segunda lição é sobre como manter coerente uma base de código gerada em volume. A OpenAI estruturou cada domínio de negócio em camadas fixas, com direção de dependência obrigatória, e passou a verificar essas regras com linters customizados e testes estruturais, escritos pelo próprio agente. O time observa que esse tipo de arquitetura costuma ser adiado até a empresa ter centenas de engenheiros; com agentes, torna-se pré-requisito desde o início.
Um detalhe técnico merece destaque: como os linters são próprios, as mensagens de erro foram escritas para conter a instrução de correção. O controle não apenas aponta o problema, mas ensina o agente a resolvê-lo. A regra é codificada uma vez e passa a valer em todo lugar ao mesmo tempo.
Separar quem faz de quem avalia
A Anthropic contribuiu com duas lições complementares sobre agentes de longa duração. Em novembro de 2025, o time relatou que um agente de código, mesmo com compactação de contexto, falhava de dois modos recorrentes: tentava construir tudo de uma vez e ficava sem contexto no meio da implementação, ou, mais adiante, observava o progresso já feito e declarava o trabalho concluído prematuramente (Anthropic).
A resposta foi um harness com duas fases. Um agente inicializador cria uma lista de funcionalidades em JSON (mais de 200 no caso relatado, todas marcadas inicialmente como falhando), um script de inicialização do ambiente, um arquivo de progresso e um commit inicial. Cada sessão seguinte trabalha em uma única funcionalidade, testa de ponta a ponta como um usuário faria e termina deixando o ambiente limpo, com commit e atualização do progresso. A escolha do formato JSON, segundo o time, se deve ao fato de o modelo ser menos propenso a alterar indevidamente esse tipo de arquivo.
Em março de 2026, um segundo relato atacou o problema da autoavaliação. Agentes tendem a elogiar o próprio trabalho mesmo quando a qualidade é medíocre. A solução, inspirada em redes adversariais generativas, foi separar um agente gerador de um agente avaliador, calibrado com exemplos e equipado com automação de navegador para testar a aplicação como um usuário. Antes de cada ciclo, os dois negociam um contrato do que significa “pronto”; em um dos casos, uma única etapa tinha 27 critérios verificáveis (Anthropic).
Os números ilustram o trade-off. Para criar um editor de jogos retrô, o agente sozinho levou 20 minutos e custou US$ 9, entregando uma aplicação cuja funcionalidade central não funcionava. O harness completo levou 6 horas e custou US$ 200, mas entregou um produto funcional. A comparação correta não é custo por execução, e sim custo por resultado utilizável.
Coleta de lixo contínua
A última lição é sobre entropia. Agentes replicam os padrões que encontram no repositório, inclusive os ruins, e isso produz deriva. O time da OpenAI chegou a dedicar toda sexta-feira, 20% da semana, à limpeza manual do que chamou de “AI slop”. A abordagem não escalou. A alternativa foi codificar “princípios de ouro” no repositório e criar tarefas recorrentes que varrem desvios, atualizam notas de qualidade e abrem pull requests pequenos de refatoração, a maioria revisável em menos de um minuto. O time compara o processo a coleta de lixo e a dívida técnica a um empréstimo de juros altos: pagar continuamente em pequenas parcelas é sempre melhor.
O peso do harness em números
| Caso | Evidência | Fonte |
|---|---|---|
| OpenAI, produto interno | ~1 milhão de linhas, ~1.500 PRs, 3,5 PRs por engenheiro por dia | OpenAI |
| OpenAI, autonomia | Execuções de mais de 6 horas em uma única tarefa | OpenAI |
| Anthropic, editor de jogos | Solo: 20 min, US$ 9, produto quebrado. Harness: 6 h, US$ 200, produto funcional | Anthropic |
| LangChain, Terminal Bench 2.0 | Do top 30 ao top 5 alterando apenas o harness | LangChain |
Além do código: harness para agentes de dados e de negócio
A maior parte da discussão pública sobre harness engineering nasceu em agentes de programação, por uma razão simples: software já dispõe de décadas de ferramentas de verificação (testes, compiladores, linters) que podem ser reaproveitadas como sensores. Mas o raciocínio se aplica integralmente a outros domínios, e é justamente neles que as empresas enfrentam as maiores lacunas.
Considere um agente de engenharia de dados operando sobre dbt e Snowflake. Seus guides incluem convenções de modelagem em camadas, contratos de dados e padrões de nomenclatura. Seus sensores computacionais já existem: testes do dbt, validação de schema, verificação de linhagem e custo de warehouse por execução. O contexto crítico, porém, raramente está disponível: quais tabelas são certificadas, quais métricas são oficiais, quais SLAs importam.
Em um agente de analytics ou text-to-SQL, o problema é ainda mais evidente. Uma consulta sintaticamente correta pode estar semanticamente errada, somando receita bruta onde o negócio esperava receita líquida. O harness adequado combina camada semântica e glossário de métricas como guides, comparação com números certificados e limites de custo como sensores, e permissões por papel como governança.
Em agentes de atendimento ou back-office, os guides são políticas e fluxos permitidos; os sensores incluem amostragem com avaliadores LLM, escalonamento por nível de confiança e auditoria de ações executadas. Em projetos de modernização de sistemas legados, a primeira tarefa do harness é reconstruir, com ajuda do próprio agente, a documentação que o legado nunca teve, e cercar o código com testes de caracterização antes de qualquer mudança.
| Caso de uso | Guides | Sensors | Contexto crítico |
|---|---|---|---|
| Engenharia de dados (dbt, Snowflake) | Convenções de modelagem, contratos de dados | dbt test, validação de schema, custo por execução | Catálogo, linhagem, SLAs |
| Analytics / text-to-SQL | Camada semântica, glossário de métricas | Comparação com métricas certificadas, limites de custo | Definições oficiais de KPI, permissões |
| Atendimento e back-office | Políticas, fluxos permitidos, tom de voz | LLM-as-judge por amostragem, auditoria de ações | Base de conhecimento versionada, histórico do cliente |
| Modernização de legado | Mapa de domínios, padrões-alvo | Testes de caracterização, diffs de comportamento | Documentação reconstruída do legado |
Em todos esses casos, observa-se o mesmo padrão: a camada de contexto e dados é a mais fraca nas organizações e a que mais determina o sucesso. Nenhum modelo chega à empresa sabendo o que ela entende por cliente ativo, margem ou churn. Essa é uma conclusão particularmente relevante para quem constrói plataformas de dados. Catálogo, linhagem, camada semântica e dados certificados deixam de ser apenas boas práticas de governança e passam a ser componentes do harness dos agentes corporativos.
Onde sua empresa está: um modelo de maturidade
Para transformar o conceito em plano de ação, a triggo.ai propõe um modelo de maturidade em seis níveis. Ele não mede o quanto a empresa usa IA, e sim o quanto o ambiente em que os agentes operam foi deliberadamente engenheirado.
| Nível | Nome | Características | Sinal de que chegou |
|---|---|---|---|
| 0 | Chat | Uso conversacional, copiar e colar, nenhum artefato persistente | O conhecimento do agente desaparece a cada sessão |
| 1 | Instruído | Arquivos de instrução e algumas skills; revisão integralmente humana | Erros repetidos ainda são corrigidos manualmente |
| 2 | Verificado | Sensores computacionais no loop; ambiente isolado | O agente corrige sozinho a maioria das falhas estruturais |
| 3 | Orquestrado | Planejador e avaliador separados; handoff por artefatos; tarefas de horas | Tarefas longas concluídas com intervenção pontual |
| 4 | Governado | Permissões, auditoria, observabilidade de custo e qualidade; portões por risco | Taxa de intervenção e custo por tarefa medidos e reportados |
| 5 | Autoevolutivo | Coleta de lixo contínua; agentes analisam traces e propõem melhorias no próprio harness | O harness melhora semanalmente sem esforço manual dedicado |
A maior parte das empresas brasileiras que a triggo.ai acompanha está entre os níveis 0 e 1. A boa notícia é que a passagem para o nível 2 costuma ser rápida, porque aproveita ferramentas de verificação que as equipes já possuem.
Um roteiro de 90 dias
Dias 1 a 30: mapa e sensores rápidos. Escolher um único fluxo de valor com alta repetição. Escrever um arquivo de instruções curto, que funcione como índice e aponte para documentação mais profunda. Conectar ao loop do agente os linters e testes que já existem. E, sobretudo, registrar cada erro recorrente: essa lista será a matéria-prima das fases seguintes.
Dias 31 a 60: legibilidade e verificação. Levar para o repositório o conhecimento tácito que hoje vive em conversas e documentos dispersos. Criar ambientes isolados por tarefa. Separar o agente que produz do agente que avalia. Transformar cada erro registrado em uma regra, um teste ou uma ferramenta, aplicando literalmente o princípio de Hashimoto.
Dias 61 a 90: governança e métricas. Definir permissões e portões de aprovação proporcionais ao risco de cada ação. Instrumentar custo, duração e taxa de intervenção humana por tarefa concluída. Iniciar uma rotina recorrente de limpeza que combata a entropia antes que ela se acumule.
Cinco métricas indicam a saúde de um harness ao longo do tempo:
- Taxa de intervenção humana por tarefa e sua tendência.
- Percentual de tarefas concluídas com evidência verificável.
- Custo e duração por tarefa concluída, e não por token.
- Reincidência de erros já catalogados, que deve tender a zero.
- Frescor da documentação em relação ao código.
Os limites e as críticas que merecem atenção
Honestidade técnica exige reconhecer que harness engineering não é consenso inquestionável, e algumas críticas são sólidas.
A mais relevante é uma aplicação da chamada Bitter Lesson de Rich Sutton: estruturas desenhadas a partir de como humanos acham que o trabalho deve ser organizado tendem a perder, com o tempo, para capacidade bruta e escala. Um harness otimizado para as limitações dos modelos de 2026 pode se tornar peso morto quando o próximo modelo for lançado, ou pior, sobreajustar-se a uma tarefa e generalizar mal para as vizinhas.
Há também evidência de que, em benchmarks isolados, a escolha do modelo ainda pesa mais que a do harness. E há o alerta contra superengenharia: a maior parte dos agentes corporativos é mais simples que os agentes de programação que dominam o debate, e nem todo caso de uso justifica planejadores, avaliadores e orquestração sofisticada (O’Reilly Radar).
Essas críticas não invalidam a disciplina, mas exigem uma distinção. Existe um harness de compensação, que supre deficiências momentâneas do modelo (decomposição forçada em etapas, resets de contexto, lembretes de planejamento), e um harness de engenharia, que codifica o que nenhum modelo trará de fábrica: o contexto de negócio da empresa, os critérios do que é correto, os limites do que é permitido e a capacidade de auditar o que foi feito. O primeiro tende a encolher; o segundo cresce em valor à medida que os agentes ganham autonomia.
A própria Anthropic oferece o melhor exemplo dessa dinâmica. Com a chegada do Opus 4.6, o time removeu a divisão em sprints e os resets de contexto que o harness anterior exigia, mas manteve o planejador e o avaliador, que continuavam agregando valor nas tarefas no limite da capacidade do modelo. O princípio enunciado é que cada componente do harness codifica uma suposição sobre o que o modelo não consegue fazer sozinho, e essas suposições devem ser testadas a cada novo modelo. A conclusão do relato é que o espaço de combinações interessantes de harness não encolhe com modelos melhores; ele se desloca.
Outras limitações também devem estar no radar. Avaliadores baseados em LLM são lenientes com saídas de LLM e precisam de calibração cuidadosa. Não existe ainda um bom mecanismo automático para a pergunta mais importante, se o sistema faz o que o negócio precisa; especificações e critérios de aceite humanos continuam insubstituíveis. Sistemas legados, onde o harness seria mais necessário, são justamente onde ele é mais difícil de construir. E práticas como a política de poucos portões de merge adotada pela OpenAI fazem sentido em ambientes de altíssimo throughput, mas seriam irresponsáveis em sistemas regulados. O próprio time adverte que seus resultados dependem da estrutura específica daquele repositório.
Essa última observação, aliás, contém o argumento estratégico mais forte a favor da disciplina: se o harness é específico do contexto, ele é também proprietário e difícil de copiar.
O harness é o ativo; o modelo é trocável
Durante os primeiros anos da IA generativa, a pergunta estratégica dominante nas empresas foi qual modelo adotar. Em 2026, essa pergunta perdeu centralidade. Modelos evoluem a cada poucos meses, convergem em capacidade e podem ser substituídos. O que permanece, acumula valor e diferencia uma organização de outra é o sistema que ela constrói ao redor deles: o conhecimento que tornou legível, as regras que codificou, os sensores que instalou, a governança que estabeleceu.
Nesse sentido, harness engineering é menos uma técnica nova e mais a reafirmação de algo que a engenharia de software sempre soube: disciplina continua sendo necessária, mas ela migra do código para a infraestrutura que produz o código. Como resume o time da OpenAI, os desafios mais difíceis passaram a ser o desenho de ambientes, loops de feedback e sistemas de controle.
Para líderes de tecnologia, dez perguntas ajudam a avaliar o ponto de partida:
- Os agentes têm um mapa curto e atualizado de onde está o conhecimento da organização?
- O que eles precisam saber está versionado, ou vive em conversas e na memória das pessoas?
- Existe ao menos um sensor determinístico rodando a cada mudança?
- As mensagens de erro dos controles ensinam o agente a corrigir o problema?
- Quem avalia o trabalho do agente é um agente diferente daquele que o produziu?
- “Pronto” é definido por evidência verificável?
- O trabalho sobrevive à troca de sessão ou de janela de contexto?
- As permissões dos agentes seguem o princípio do menor privilégio?
- A taxa de intervenção humana e o custo por tarefa são medidos?
- A cada novo modelo, testa-se o que pode ser removido do harness?
A triggo.ai apoia empresas em todas as etapas dessa jornada, do diagnóstico de maturidade agêntica à construção de harnesses para agentes de dados, analytics e processos de negócio, com especial atenção à camada que mais determina o sucesso: o contexto de negócio certificado sobre o qual os agentes raciocinam. Para entender em que nível sua organização está e qual o próximo passo, fale com a triggo.ai.
Receba conteúdos de Data & AI
Insights práticos sobre IA, Data Products e Agentes — sem spam.
triggo.ai
Soluções e Produtos de Data & AI para empresas que buscam escala e impacto real.