Abordagem moderna de DataOps usando DBT
A Dbt Labs é vista como líder de mercado na categoria de transformação de dados, que é uma parte da data stack moderna.
O ‘Agile Manifest’ desencadeou uma série de transformações nos processos de desenvolvimento, dando origem a novos paradigmas, metodologias e práticas. O DataOps, derivado do DevOps, é um desses frutos, cuja primeira citação foi em 2017, no artigo “3 Reasons why DataOps is Essential for Big Data Success”.
Segundo um artigo publicado pela IBM, DataOps (Data Operations) é a orquestração de pessoas, processos e tecnologias com o intuito de proporcionar dados de maneira rápida e confiável, para que sejam entregues aos responsáveis pela governança de dados ou para a aplicação direta nos negócios, tanto em operações ou em aplicativos como na inteligência artificial.
O DataOps permite aumentar a velocidade e a escala das operações através de todo o ciclo de vida dos dados. Outra definição, mais simples, é que DataOps é a busca por formas mais rápidas e eficientes para acelerar o lançamento de soluções analíticas. Tarefas que demoravam 2 semanas ou mais, com a adoção de DataOps podem ser feitas em 1 ou 2 dias.
Geralmente, os engenheiros de dados perdem 75% do seu tempo processando tarefas manuais. Confira, no diagrama abaixo, uma representação dos principais problemas que o DataOps pode resolver visando acelerar uma entrega.
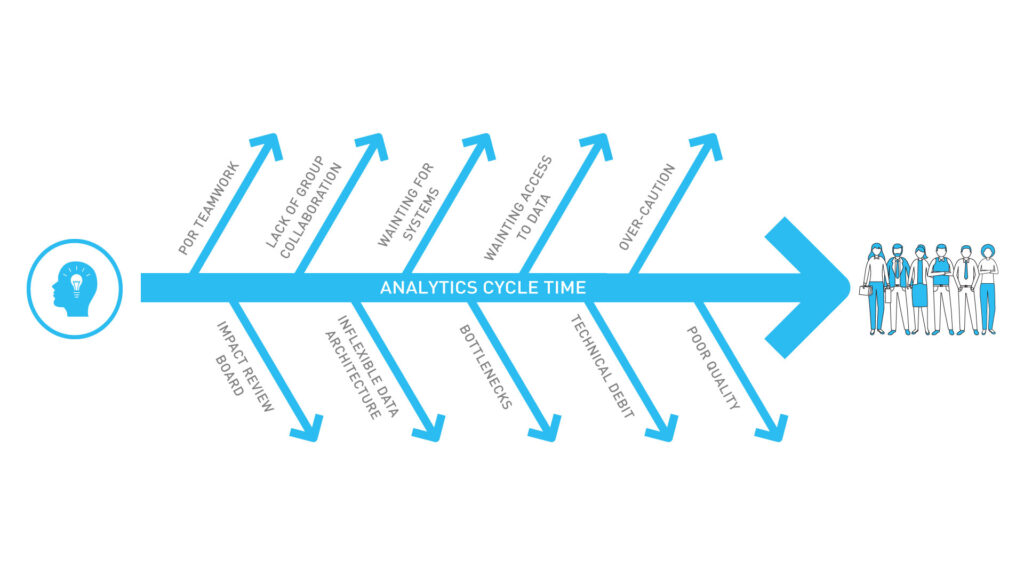
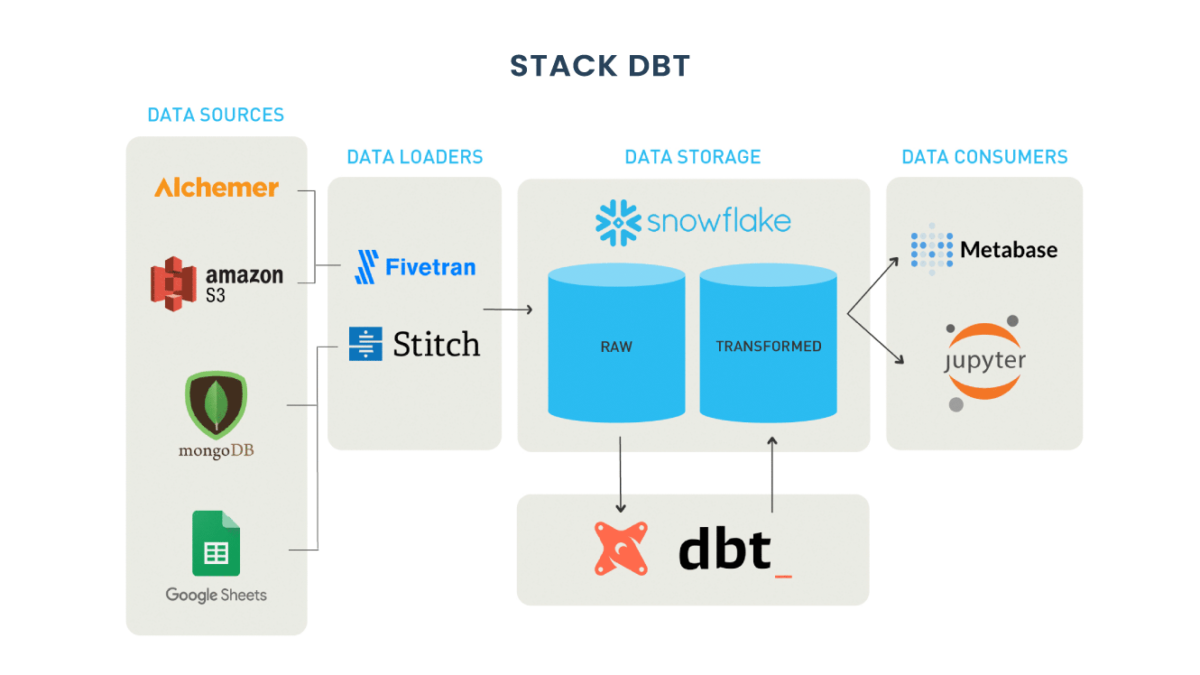
Nesse contexto, vamos apresentar agora o DBT (Data Build Tool), ferramenta que potencializa e simplifica os pipelines construídos com o Snowflake. Juntas, essas duas ferramentas são capazes de viabilizar uma esteira eficaz e completa de DataOps.
Arquitetura Moderna usando DBT
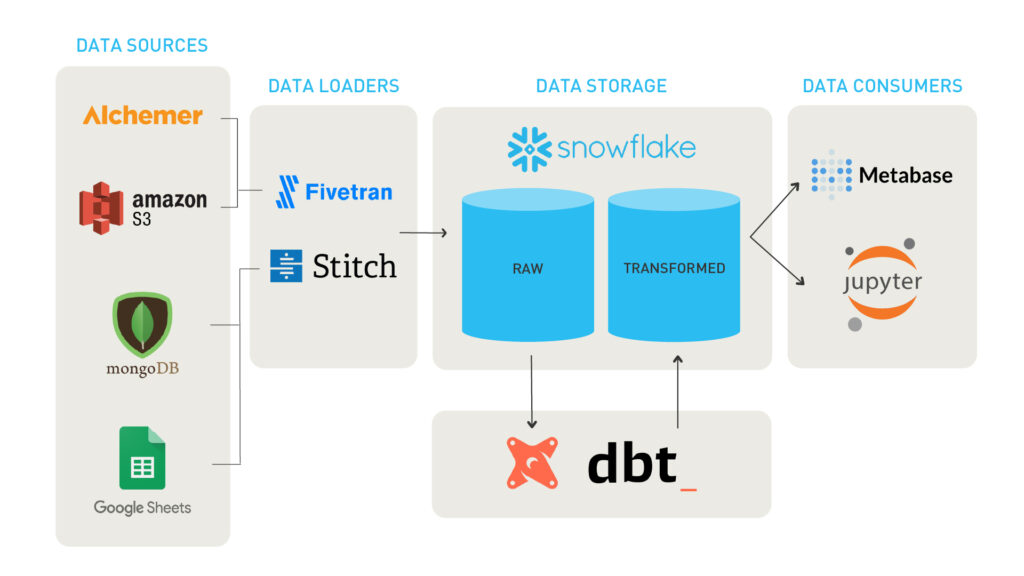
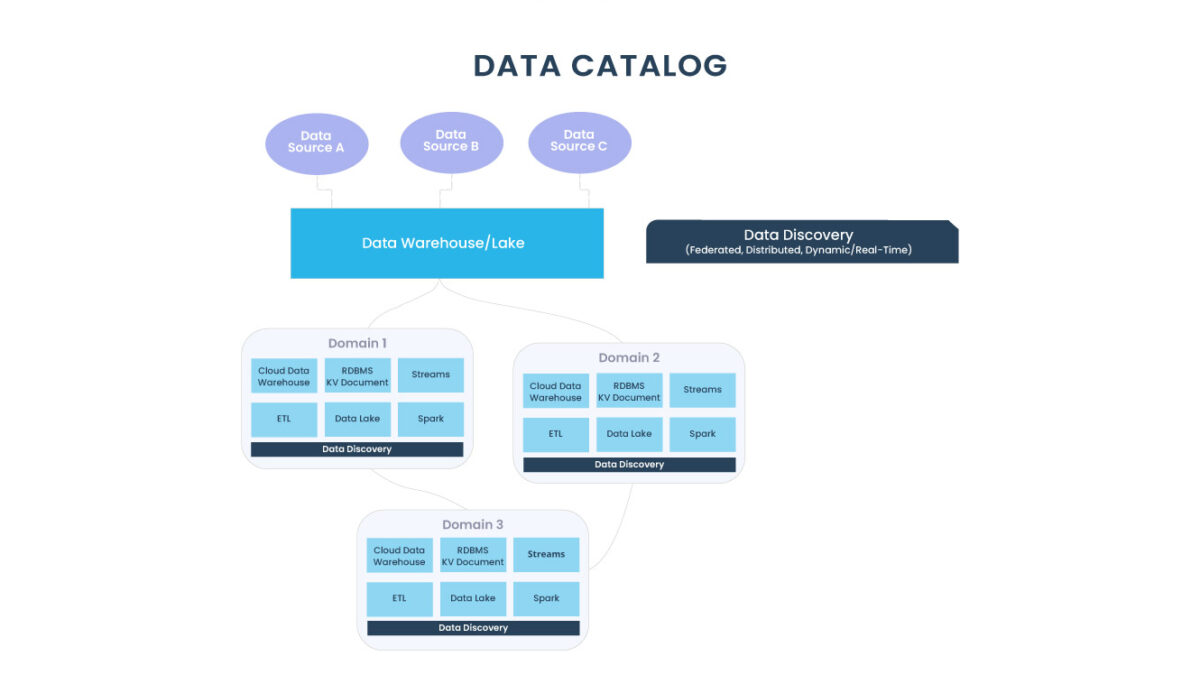
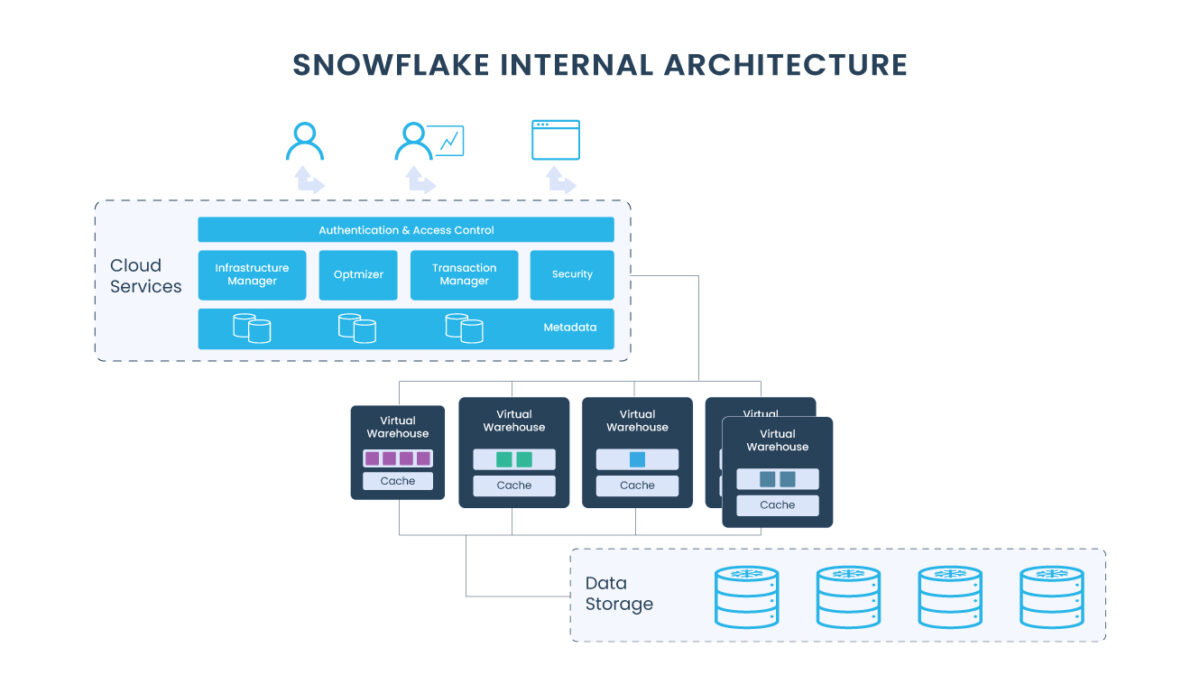
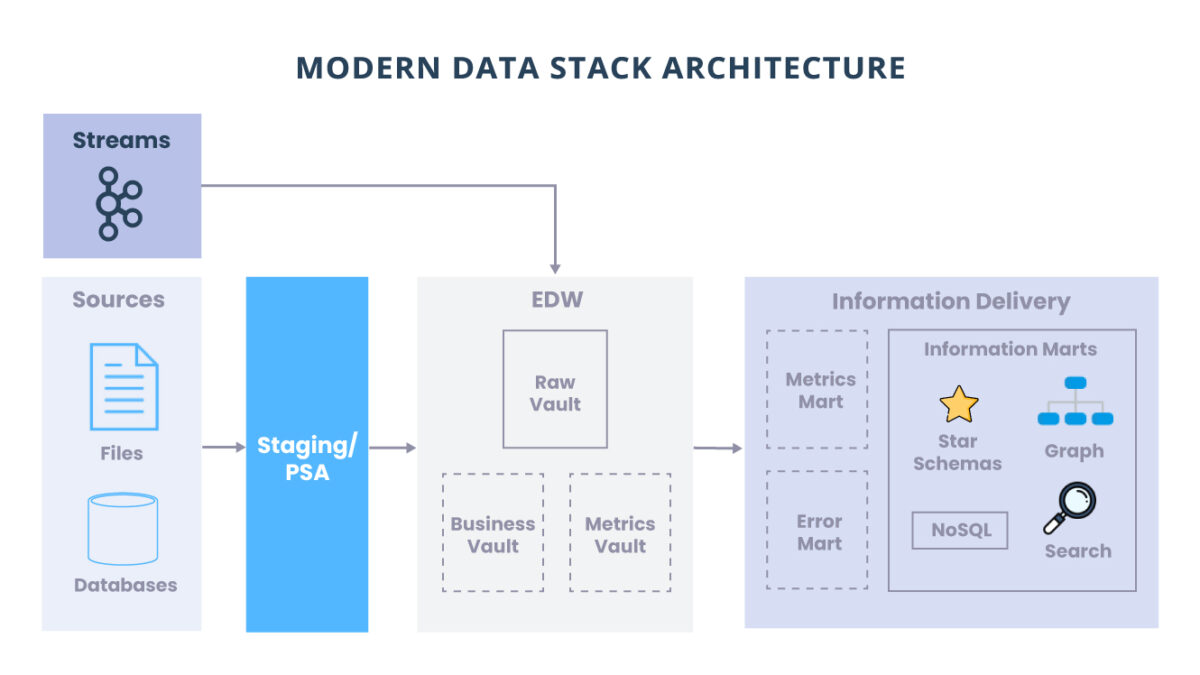
Um ecossistema moderno de Cloud Data (Data Warehouse, Data Lake, Data Mart, Open Data Store) suporta diversas linguagens de programação (Python, Java, .Net, Node, C e SQL Alchemy) e serve para propósitos diversos, tais como Machine Learning, Data Science, Business Intelligence e Data Integration. Muitas empresas, ao redor do mundo, adotaram e estão sendo surpreendidas com o valor que a nova data stack entrega ao negócio e como a separação da camada de armazenamento da camada computacional proporciona uma escalabilidade quase infinita com custo viável.
O DBT (Data Build Tool) inova completamente a forma de orquestrar ELT (Extract Load and Transform). Sendo responsável pela transformação, o DBT traz para a engenharia de dados a possibilidade de tratar dados utilizando SQL. Para o DBT as queries são modelos que representam tabelas e views. Esses modelos podem ser versionados e seus esquemas e dados podem ser testados (muito similar aos testes unitários).
Os modelos podem ser vinculados para formar um DAG (Directed Acyclic Graphic), semelhante ao modelo computacional usado pelo Spark e Tensorflow. O DAG representa não só a ordem de execução das queries, mas também a linhagem dos dados gerados através dos modelos.
Anatomia de um projeto DBT
O DBT foi construído com Python e pode ser instalado usando o pip. Uma vez que o dbt é instalado, um novo projeto pode ser criado com o comando: dbt init nome-do-projeto.
Todos os arquivos em um projeto dbt são dos tipos .md, .yml ou .sql sendo que:
- .md – são arquivos de documentação para os modelos. São na verdade uma variação do markdown;
- .yml – são arquivos de configuração do projeto. O principal é o dbt_project.yml;
- .sql – usados para construção dos modelos e testes.
Artefatos do projeto
Os artefatos em um projeto DBT são divididos em:
– Models
São o coração do DBT, pois, no workload de ELT, são responsáveis pela Transformação(T). São sempre selects que o DBT materializa como views ou tables (permanentes ou efêmeras). Eles formam uma sequência de execução, referenciando outros modelos.
– Tests
São arquivos .sql usados para fazer teste de qualidade nos dados. É possível testar constraints de Unique Key, Not Null e range de valores.
– Macros
São funcionalidades construídas com templates utilizando Jinja. São usados para construir funcionalidades mais avançadas que o sql puro permite, com loops, declaração de variáveis, funções, etc.
– Analysis
São modelos diferentes que não rodam no deploy do projeto. São pseudos modelos que precisam ser compilados e não executados. Não são materializados em views nem em tabelas, mas são ligados em soluções analíticas como pipelines de Data Science.
– Docs
São artefatos opcionais, mas extremamente úteis, que permitem criar uma documentação dos modelos. Para isso é usada uma linguagem muito similar ao conhecido markdown.
– Logs
O DBT possui uma poderosa funcionalidade de logs. Quando o comando ‘dbt run’ é executado, o DBT cria logs dos modelos, dos testes e das macros, na pasta logs.
– Packages
São bibliotecas produzidas para modularizar o código. São de fato projetos DBT, que você pode utilizar para solucionar um determinado problema.
Agora que você já conhece um pouco mais sobre o DBT, vale ressaltar que a ferramenta caiu como uma luva nesse novo paradigma, potencializando todas as práticas do manifesto ágil. Ao trocar a ordem da operação dos dados de ETL (Extract Transform and Load) para ELT(Extract Load e Transform), a engenharia de dados resolveu problemas de complexidade, desempenho e disponibilidade que existiam nos antigos Data Warehouses.
Não perca os próximos capítulos dessa jornada
Os dados são o combustível da inovação, portanto uma esteira fluída de DataOps estimula a agilidade de equipes e processos. Agora que você já entendeu a anatomia do DBT e o papel fundamental que ele desempenha em DataOps, não perca os próximos artigos, pois traremos hands-on de projeto DBT, integração contínua do DBT com git, ambientes de desenvolvimento (DBT local dockerizado) x ambiente de produção (DBT Cloud), linhagem de dados, testes e outros aspectos que o DBT proporciona.
A triggo.ai é pioneira e especialista em MDS – Modern Data Stack & DataOps, desenvolvemos produtos e soluções que permitem nossos clientes atingir o melhor ROI para Data Analytics & AI. Fale com um de nossos especialistas!